2026年10月22日、AWSはAmazon SageMaker AIにおいて、Muse Glimmer、Qwen3.8 27B、Ministral 3(3B・8B・14B)をサーバーレスモデル調整の対象に追加したと発表しました。詳細はAmazon SageMaker AIのモデル調整に関する公式発表で案内されています。今回の追加により、インフラのプロビジョニングや学習オーケストレーションをSageMaker AI側に任せながら、東京リージョンを含む環境でこれらのモデルを用途に合わせて調整できるようになりました。
案内されている調整手法には、教師あり微調整(SFT)のほか、出力の好ましさを整えるDPO(Direct Preference Optimization)、報酬信号を用いて最適化するRFT(Reinforcement Fine-Tuning)が含まれます。また、モデル更新の深さに応じてLoRAまたはフルファインチューニングを選択できる構成となっています。
モデル調整の前に確認したい「問題の性質」
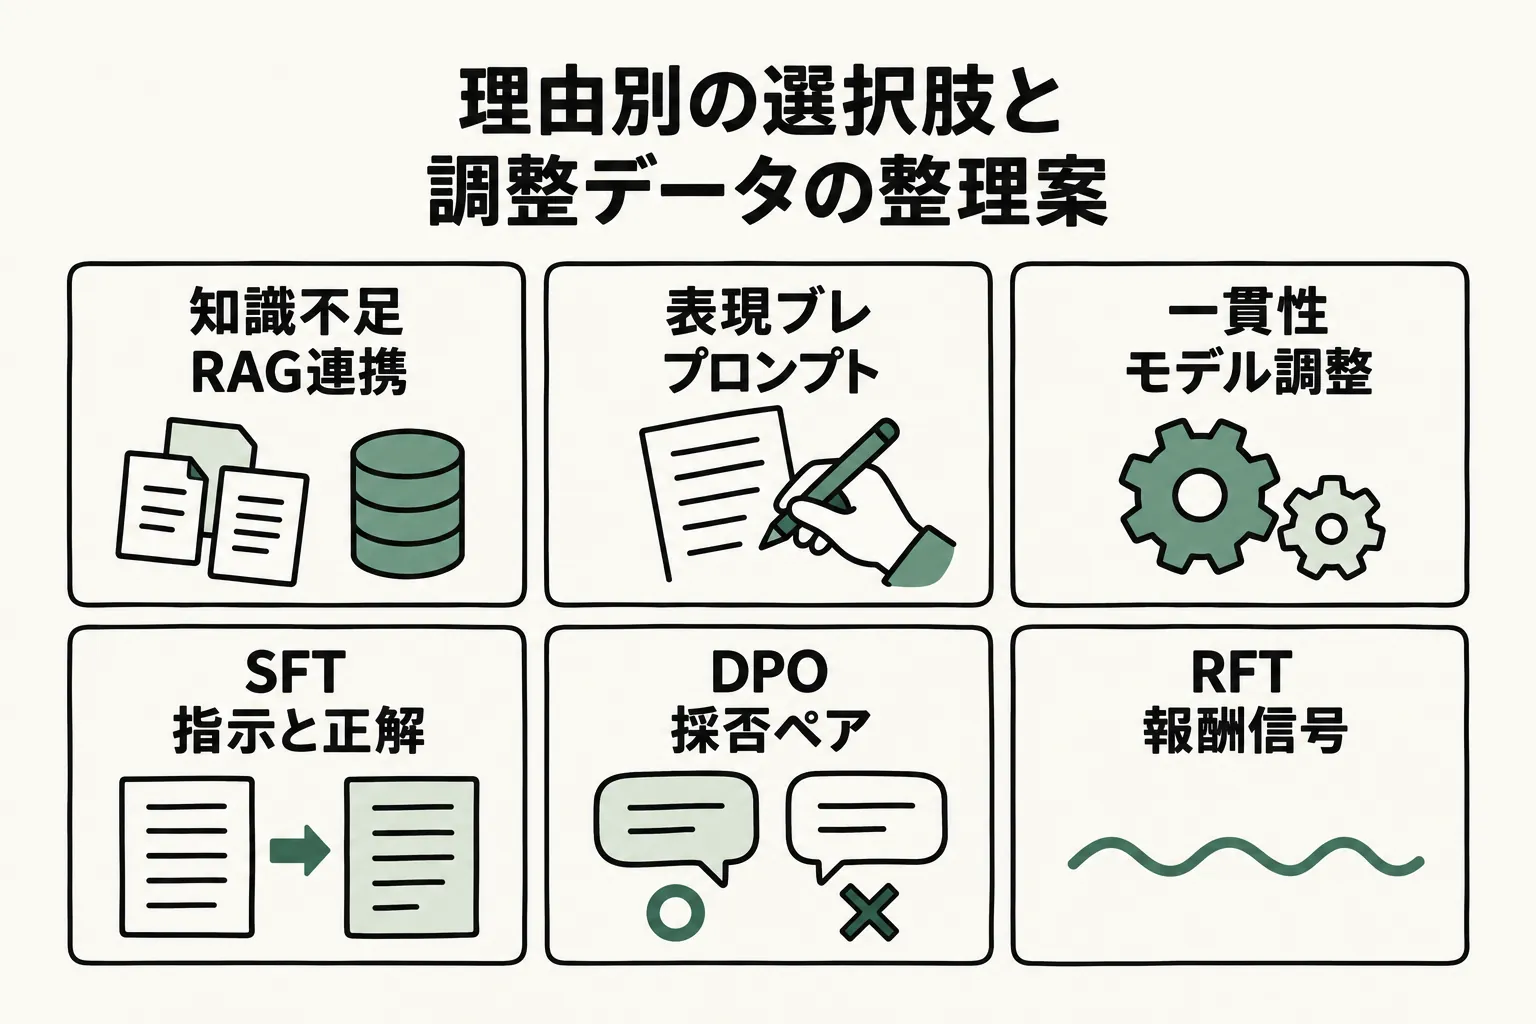
新しいモデルの調整環境が整うと、現場に溜まっている回答履歴をすぐに学習させたくなるかもしれません。しかし、SageMaker AIのモデルカスタマイズ公式ガイドでは、ファインチューニングに着手する前に、よりシンプルな手段で要件を満たせないかを検討することが推奨されています。
公式ガイドでは、トーンや形式、表現方法の改善であればプロンプトエンジニアリングを、特定ドメインの知識不足であれば再学習を伴わないRAG(検索拡張生成)による外部知識の補強を選択肢として挙げています。一方で、モデルの重み自体を変更するファインチューニングは、新しい振る舞いや文体、専門領域の判断を一貫してモデルへ獲得させたい場合に適した手段です。
調整手法ごとに求められるデータの形式も異なります。SFTではラベル付けされたプロンプトと回答のペアが必要ですが、DPOでは好ましい回答と却下された回答の比較ペアが求められ、RFTでは報酬信号による最適化が行われます。単に過去の修正ログを保存しているだけでは、手法に応じたデータ形式が揃わない点に注意が必要です。
回答の修正理由からアプローチを切り分ける
社内の問い合わせ対応業務を例に考えてみます。たとえば自社製品や取引条件を扱う卸売企業の顧客対応窓口において、AIが生成した回答を担当者が修正して送信している状況を仮定します。
このとき、蓄積された修正履歴をそのまま学習データへ投入するのではなく、まず修正の「理由」を分類することが実務的な第一歩です。修正理由が「最新の在庫状況や改定された規約をAIが知らなかった」という知識不足によるものであれば、モデルを再学習させるのではなく、社内データベースや規約文書を検索してプロンプトへ注入するRAGの仕組みを整えるほうが適しています。
一方で、必要な情報はプロンプトに含まれているにもかかわらず、社内特有の言い回しや顧客の状況に応じた優先順位付けが安定しない場合は、プロンプトの調整や、採用された回答と却下された回答の比較データを用いたDPOなどのモデル調整が検討対象に入ってきます。
自社のデータと既存システムで進める準備
業務改善を社内で具体化する際は、まず最近修正された回答履歴を取り出し、内容の補足だったのか、回答形式や言葉遣いの修正だったのかを突き合わせてみることが有効です。あわせて、回答の根拠となる社内規約や製品情報の更新経路が整理されているかを確認します。
また、実務運用を見据えると、モデルの調整作業そのものだけでなく、既存の顧客管理システムから回答履歴を安全に抽出する処理や、現場の担当者が生成回答を確認・修正して結果を記録する業務画面の設計が重要です。サーバーレス環境によって学習基盤の構築負担は軽くなります。ただし、自社業務の入出力とモデルをつなぐ連携については、既存機能や標準連携で対応できる範囲を踏まえ、不足する部分の個別設計や開発を検討する必要があります。
デノフへのご相談について
デノフでは、Web・システム開発とAI活用支援を通じて、問い合わせ対応をはじめとする業務の整理、AIを活用するプロセスの選定、ツールや改善手法の選定を支援しています。社内データの参照連携やプロンプトの改善、既存の顧客管理システムと連動した回答確認画面の構築など、自社の運用に合わせた仕組みづくりを検討されている方は、デノフのお問い合わせ窓口よりお気軽にご相談ください。