AWSは2026年10月22日、Amazon SageMaker AIのサーバーレスモデルカスタマイズにおいて、学習操作をきめ細かく制御できるtraining session APIsの一般提供を開始したと発表しました。対象地域は米国東部(バージニア北部)、米国西部(オレゴン)、アジアパシフィック(ムンバイ)です。詳細はAWSによるtraining session APIsの発表で確認できます。
状態を保持するセッションと操作単位のAPI
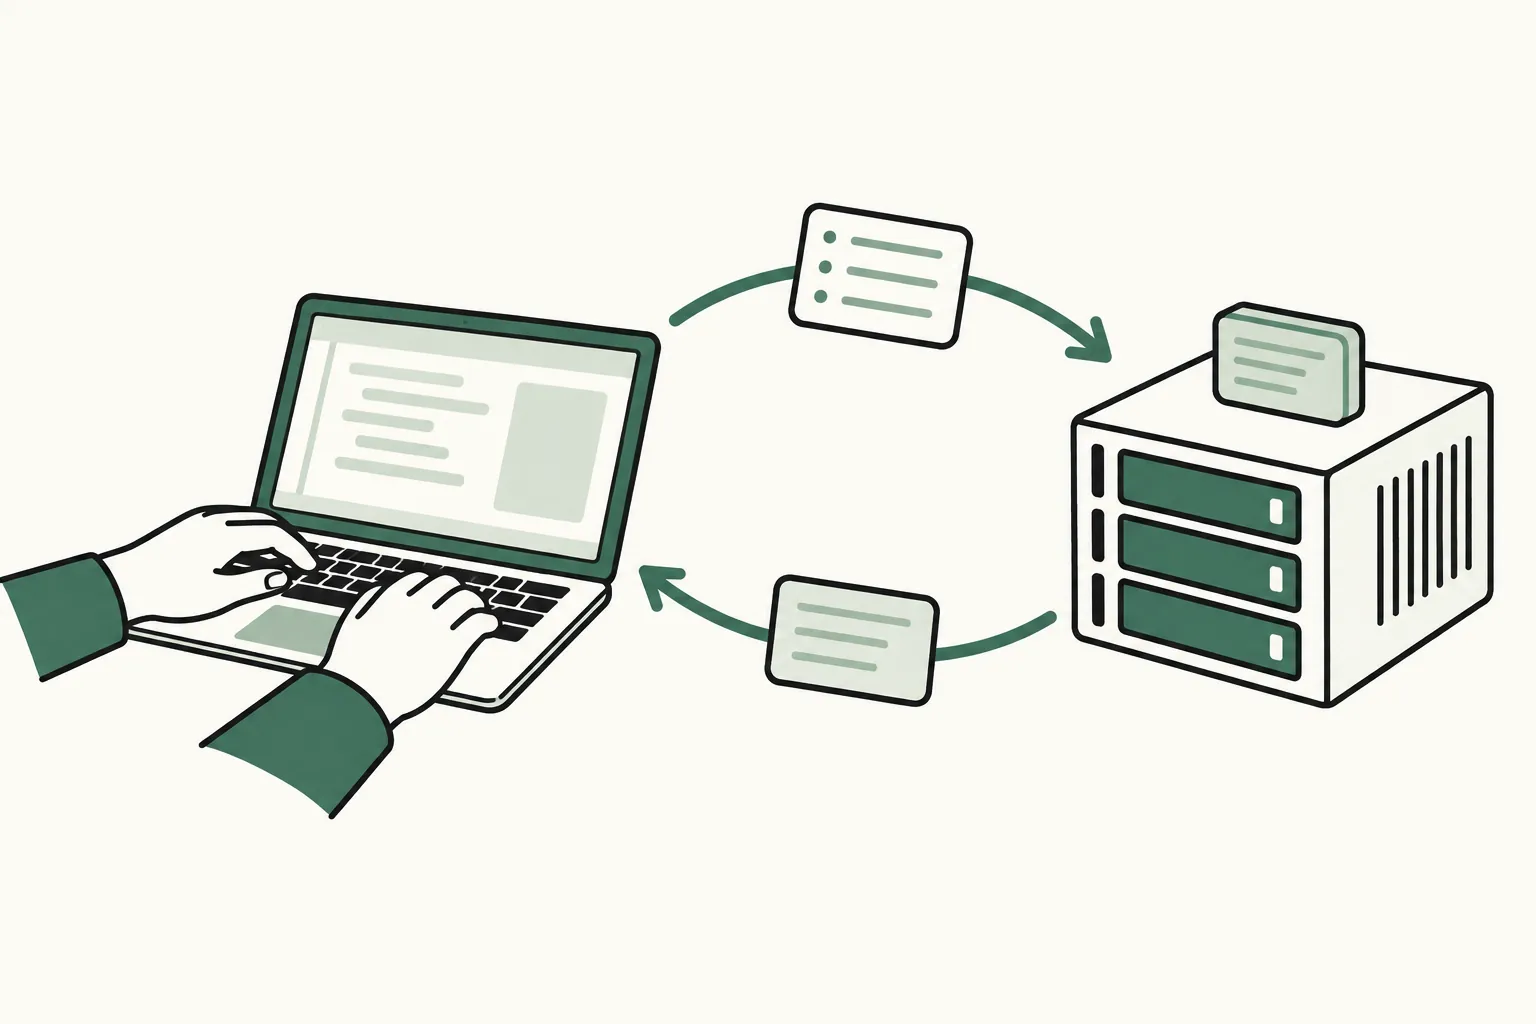
これまでのマネージドな追加学習では、教師あり微調整(SFT)などの決まったワークフローにデータとモデルを渡して実行するのが一般的でした。これに対し、training session APIsでは利用者がPythonコードを用いて学習ループそのものを記述します。
具体的には、推論サンプリングを行うsample()、順伝播と逆伝播を実行するforward_backward()、重みを更新するoptim_step()といった単位でAPIを呼び出します。GPU上にモデルやLoRAの重みを読み込んだ状態はセッション内で保持されます。呼び出しごとに初期化されないため、強化学習の反復や独自の損失関数の適用、データカリキュラムの変更を段階的に進めることが可能です。GPUの割り当て、分散実行、勾配同期、障害復旧、チェックポイントの保存といった基盤管理はAWS側が処理します。
既存の方式とどう選び分けるか
独自の手順を組める自由度がある一方で、実装上の役割分担を理解しておく必要があります。SageMaker AIの技術文書では、学習ループを動かすPythonコードの記述が必要であることとともに、他の選択肢との関係が示されています。
プログラミングを伴わずに標準的な微調整を行いたい場合はServerless model customizationの管理ワークフローが適しており、完成した学習スクリプトを一括実行するジョブ形式であればSageMaker AI Training Jobsが向いています。独自の強化学習アルゴリズムや業務固有の採点基準を学習ステップごとに反映させたい場合に、training session APIsの検討価値が生まれます。
業務固有の評価基準を接続する試行の考え方
基盤運用の手間が軽減されても、「何を学習の正解とし、業務に適合しているかをどう判定するか」という設計責任は利用者側に残ります。
たとえば架空の検討例として、社内の保守問い合わせを受け付け区分へ自動分類するシステムを考えます。既存のルールや標準モデルでは誤分類が頻発する境界事例に対し、担当者が確定した過去の判断理由をもとに独自の評価処理を組み、出力結果を採点して学習ループにフィードバックする構成が考えられます。
このような取り組みを進める際は、いきなり全体を自動化するのではなく、まず現状の誤り傾向を把握し、学習用データとは別に検証用データを確保したうえで、判定処理の妥当性を小さく確かめることが重要です。既存の受付システムが求める形式と、業務上の正解基準を明確に区別して整理することで、過剰な追加開発を避けられます。
デノフでの検討とご相談
AIモデルの調整においては、インフラ技術の選択だけでなく、現場の業務データや既存システムとの接続境界をどう設計するかが成果を左右します。
デノフのサービス案内では、業務の整理からAIを活用する業務の選定、ツール選定、既存のWeb・業務システムとの連携開発や運用保守まで一貫した支援が可能です。独自モデルの学習が必要なのか、既存ツールの組み合わせで解決できるのかの切り分けや、試作に向けた評価データの整理について具体化したい場合は、デノフへの相談窓口からお問い合わせいただけます。