社内検索や問い合わせ対応など、業務システムの中で埋め込みモデルや再順位付けモデル、分類モデルといった比較的小規模なモデルを運用する場面があります。しかし従来のSageMaker AIでは、モデルごとにアクセラレータ全体を割り当てる必要があり、モデルが使い切れないGPU容量に対しても1基全体を占有させる構成となっていました。
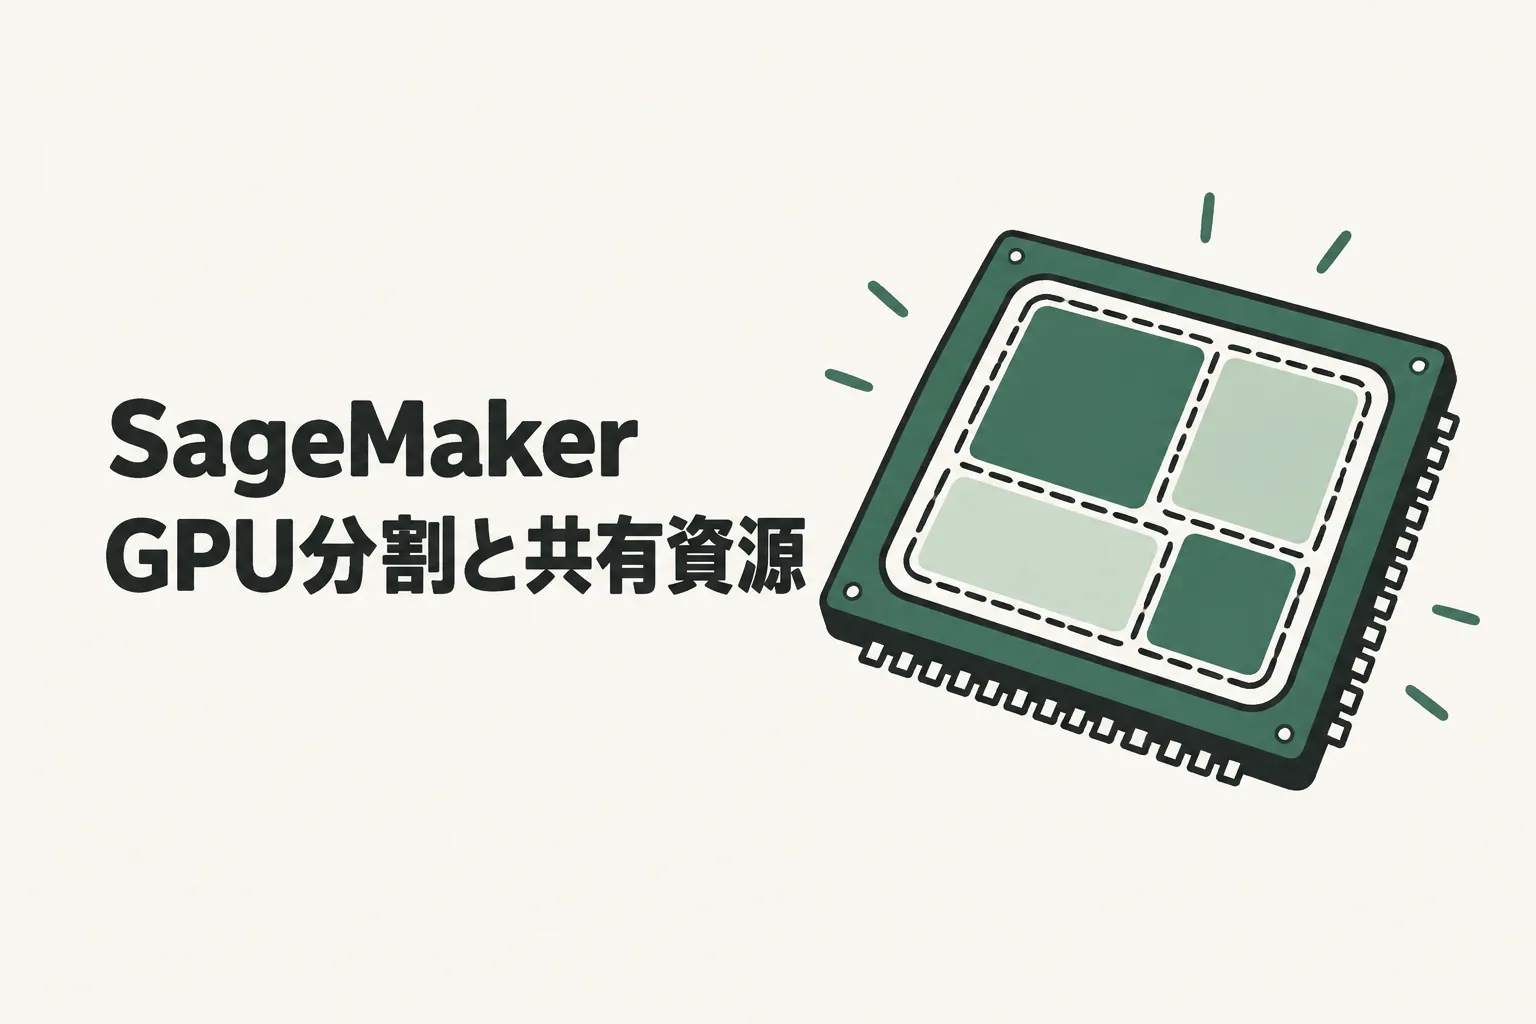
こうした背景に対し、AWSは2026年10月30日、Amazon SageMaker AIのリアルタイムエンドポイントにおけるGPU partitioning対応の発表を行いました。単一GPUを独立した区画に分割し、複数の推論コンポーネントを同居させることが可能になっています。
GPU partitioningの仕組みと資源の分離範囲
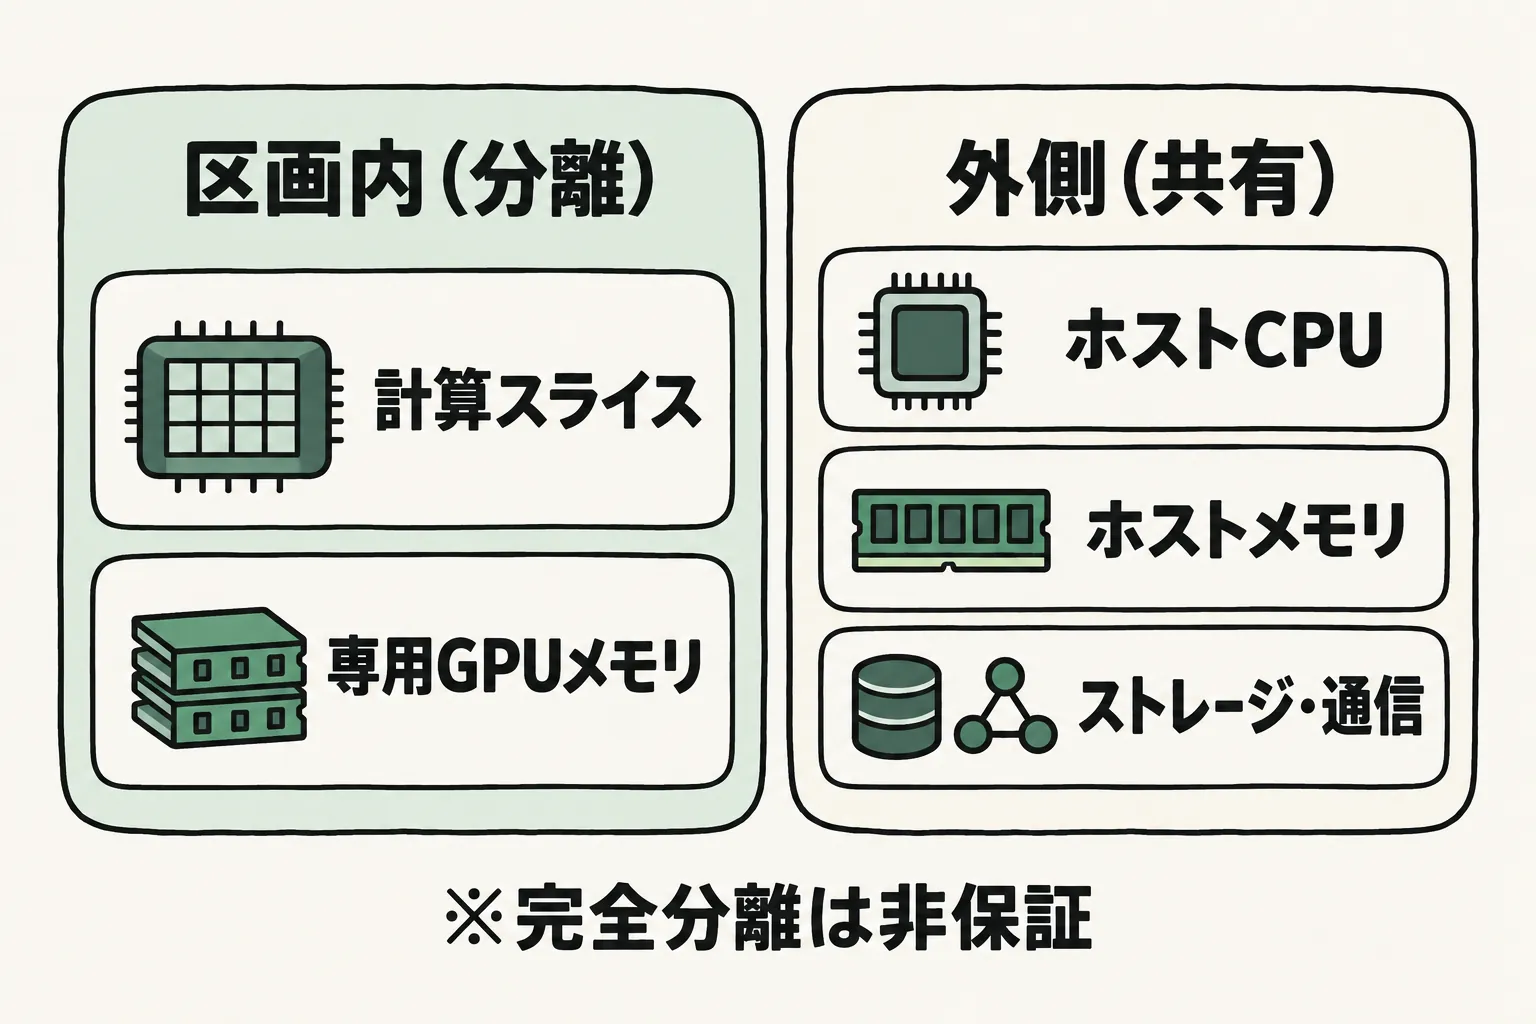
SageMaker AIのGPU partitioningは、NVIDIA Multi-Instance GPU(MIG)技術を利用して、物理的な1基のGPUを最大7つの独立した区画に分割する機能です。公式ドキュメントであるSageMaker AI開発者ガイドのGPU partitioning解説によると、各区画には固定の計算スライスと専用のGPUメモリブロックが割り当てられます。これにより、あるモデルへのアクセスが急増しても、隣接する区画の計算性能やGPUメモリを圧迫しないハードウェアレベルの分離が確保されます。
ただし、分離される範囲には注意が必要です。公式ガイドに明記されているとおり、GPUの計算スライスとGPUメモリは独立していますが、同じインスタンス上で動作する各モデルは、ホスト側のCPU、ホストメモリ、ストレージ、ネットワーク帯域を引き続き共有します。そのため、GPU処理の前後に発生するデータの前処理やトークナイズ、ネットワーク転送などの処理が重なると、ホスト側の負荷がボトルネックになる可能性があります。
設定項目と運用時の主な制約
GPU partitioningの有効化は、エンドポイントの作成時に設定します。プロダクションバリアント側でGPUの分割方法を指定するAcceleratorPartitionLayoutsと、個々の推論コンポーネントをどの区画種別へ配置するかを指定するAcceleratorPartitionTypeという2つのAPIフィールドが用意されています。アプリケーションからの呼び出しは従来どおり推論コンポーネント名で行うため、リクエスト側に区画情報を含める必要はなく、既存のクライアントコードを変更せずに呼び出せる設計です。
一方で、実際の運用保守においては2つの重要な制約を把握しておく必要があります。
1点目は、稼働中のエンドポイントに対して分割レイアウトを動的に変更できない点です。運用途中で区画サイズや分割数を変更したい場合は、新しいレイアウトを定義した別のエンドポイントを新規作成し、トラフィックを新しいエンドポイントへ切り替える必要があります。異なる分割レイアウトを指定したエンドポイント設定に対してUpdateEndpointで更新しようとすると、400エラーが返される仕様となっています。
2点目は、CloudWatchで取得できる監視指標の範囲です。GPU partitioningを適用したエンドポイントおよび推論コンポーネントでは、GPU使用率、CPU使用率、メモリ使用率のメトリクスが公開されません。運用監視で利用できるのは、エンドポイントが公開する呼び出し回数やレイテンシなどの指標となります。従来のようにハードウェアリソースの使用率をトリガーにして負荷を検知していた環境では、監視設計の見直しが求められます。
なお、対応するインスタンスファミリーはP4d、P5、G7、G7eとなっており、利用可能なリージョンには東京(ap-northeast-1)が含まれます。ただし、インスタンスの提供状況はリージョンによって異なるため、対象リージョンでの在庫状況やエンドポイントの利用クォータを事前に確認することが推奨されています。たとえばP4dインスタンスで特定の区画構成(mig-1g.10gbなど)を利用する際には、AMIのバージョン指定が必要になるといった細かな条件も案内されています。
国内の社内検索システムを想定した検証の進め方
この機能を実務にどう活かせるか、国内企業における社内文書検索システムを仮定例として考えてみます。このシステムでは、社員が検索窓に入力したクエリをベクトル化する埋め込みモデルと、検索結果の上位候補を精度高く並び替える再順位付けモデルの2つを運用していると仮定します。
どちらのモデルも常時高負荷というわけではなく、1基のGPU全体を占有させるには余剰が生じている場合、GPU partitioningによる同居が有力な検討対象になります。ただし、業務利用では社員からの通常検索と、夜間や定期バッチで行われる社内文書の更新・再インデックス処理が重なる時間帯が存在します。
GPU自体のメモリは分離されているもののホスト資源は共有されるため、まずは検証環境において、各モデルを単独で実行した場合の応答時間と、同時に負荷をかけた場合の応答時間を計測・比較することが実用的な第一歩となります。また、将来的にモデルのサイズ変更や区画構成の変更が必要になった際に備え、接続先エンドポイントをスムーズに切り替えられる構成や、切り戻し手順を事前に整理しておくことが大切です。
業務整理からシステム接続まで
新しいインフラ機能が登場した際、設定手順そのものだけでなく、「自社のどの業務処理を同居させるべきか」「既存のWebシステムや社内APIとの接続をどう管理するか」といった全体設計が成果を左右します。
デノフでは、Webサイト・業務システムの設計・開発・運用保守やAI活用支援を手がけています。業務課題の整理からAIを活用する処理の選定、既存システムと外部推論APIをつなぐ接続設計、小規模な検証から運用保守を見据えた実装範囲の具体化まで対応しています。
社内システムの改善やAIモデルの効率的な運用について、要件が固まりきっていない段階でも、現在のシステム構成や業務の流れに合わせた進め方を整理できます。推論処理の配置や連携方法にお悩みの方は、デノフへの相談窓口よりお気軽にお問い合わせください。