自由入力の問い合わせに、小さな意味判断だけを足す考え方
日々の業務で寄せられる問い合わせには、急ぎのクレームから日常的な質問、仕様の確認まで多種多様な内容が含まれます。多くの企業では、担当者が受信トレイをすべて開き、文面を最後まで読んでから担当部署へ転送したり、対応の優先度を判断したりしています。この仕分け作業を効率化しようとするとき、本文に含まれるキーワードによる条件分岐を試みるケースは少なくありません。しかし、「返品」という言葉が含まれていても、実際に商品を返品したい場合もあれば、「返品の手続きについて事前に確認したい」という質問であったり、「明日の作業に間に合わせるため、返品ではなく至急交換してほしい」という緊急のトラブルであったりします。言葉の表面的な一致だけに頼ると、誤った振り分けが発生しやすくなります。
一方で、大型の生成AIを導入して文章作成まで含めた全自動の返信を行わせようとすると、誤った回答を出力するリスクへの対策や、社内ルールとの整合性の担保が重い課題になります。そこで有効になるのが、システム全体をAIに置き換えるのではなく、問い合わせの意図や緊急度といった「小さな意味の判断」だけをピンポイントで既存のプログラムから呼び出すアプローチです。すべてを自動化するのではなく、担当者が判断するための補助材料を揃える設計にすることで、既存の業務フローを壊さずに確認の負担を軽減できます。
TypeSafeのJevとは何か:文章生成ではなく判定結果を返すモデル
こうした小さな意味判断を部品として扱う技術例として、TypeSafe社が提供しているJevというモデルがあります。Jevは、チャットボットのように自由な文章を対話形式で生成する一般的なLLMとは性質が異なります。入力された文章やデータに対して、あらかじめ開発者が定義した質問と基準を渡し、その評価結果をプログラムで扱いやすい構造化データとして受け取るためのモデルです。一般的なノーコードツールのように画面上の設定だけで導入が完結する完成品アプリケーションではなく、開発者がAPIを通じてシステムへ組み込むための基盤部品として提供されています。
JevのAPI仕様は、TypeSafe AIのAPIリファレンスで公開されています。具体的には、評価対象となる文章や状態データとともに、名前を付けた質問を渡すと、それぞれの質問に対する判定値が返ってくる仕組みです。質問の形式にはいくつかの種類が用意されています。はい・いいえの確率を数値で返すNoul、あらかじめ定義した複数の選択肢から最も当てはまる項目とそれぞれの確率分布を返すChoice、そして複数の基準段階に沿って評価値を返すScoreなどがあります。返り値が自由な長文ではなく、決まった形式の数値や選択肢として得られるため、プログラム側の条件分岐や既存データベースへの保存が容易に行える点が大きな特徴です。
公式例にみるIntent routing:問い合わせ内容に応じた処理の振り分け
TypeSafe社が公開している技術資料の中に、問い合わせを適切に振り分けるための設計パターンとしてIntent routingの実装例が紹介されています。これは特定の海外企業における成功実績を報告したものではなく、問い合わせの意図や複雑さに応じて処理先をどのように分けるかを説明するために提供元が作成した実装サンプルです。
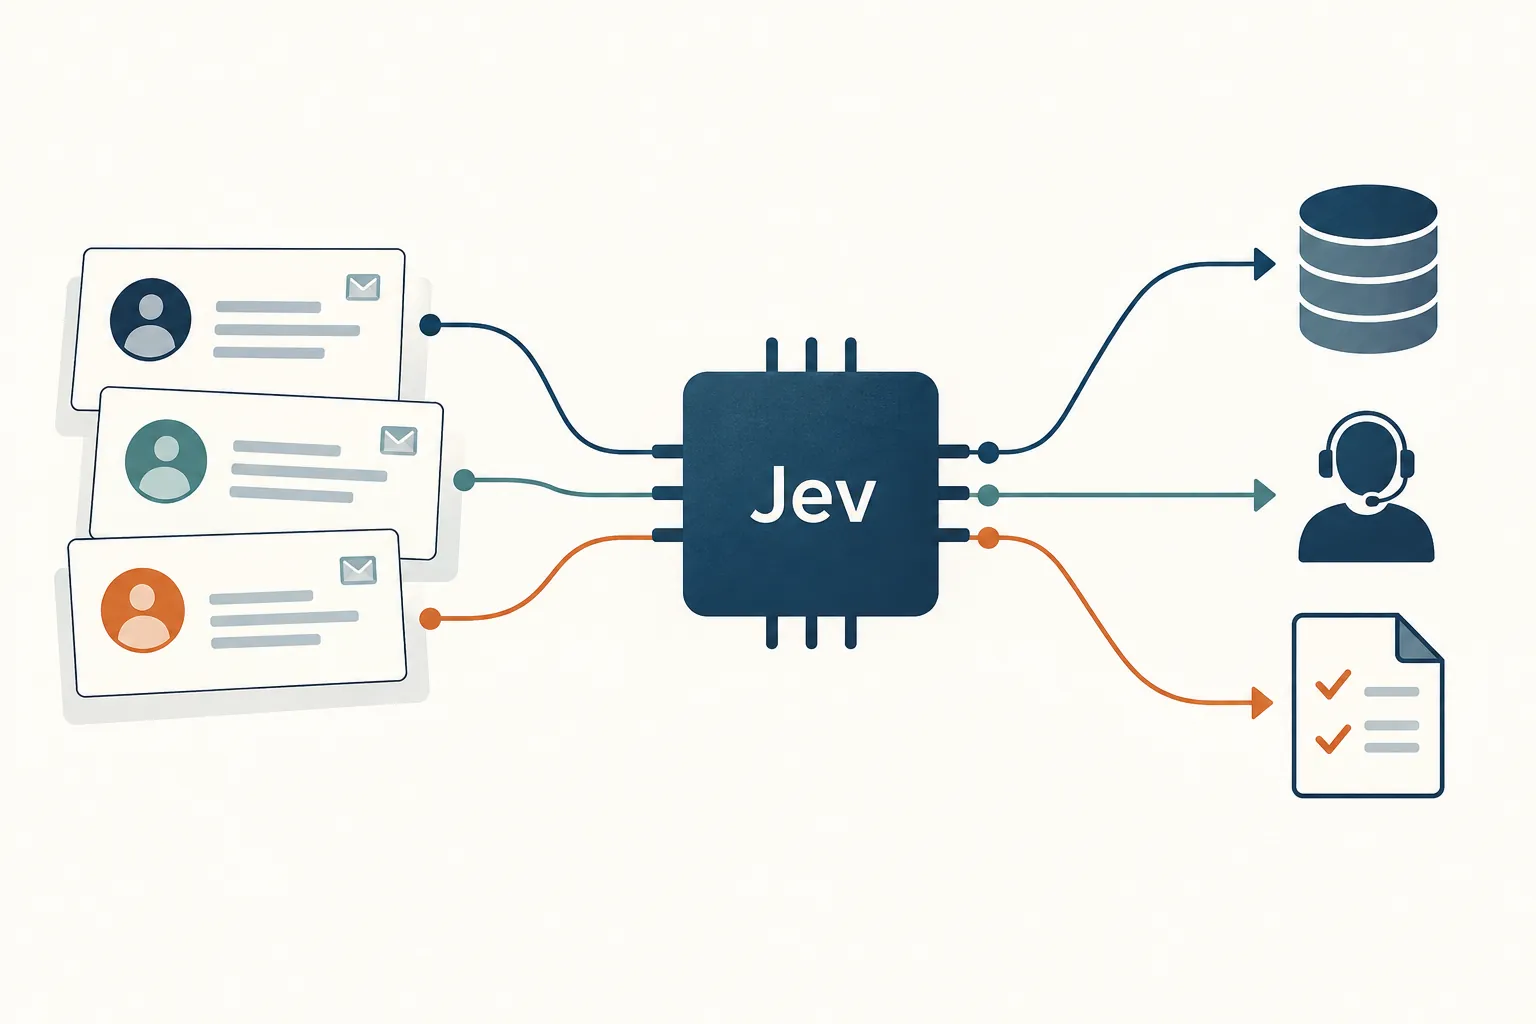
この実装例では、まず届いた顧客メッセージに対して、問い合わせの主要な意図を判定するChoice質問と、対応の複雑さを測るScore質問を同時に投げかけます。判定結果を受け取ったプログラムは、最初に意図の判定確信度が基準値を満たしているかを確認し、確信度が不足していれば即座に人間の担当者へ振り分けます。基準を満たした場合、注文状況の確認であればデータベースを参照する決定的なコードへ渡し、商品への質問や返品・交換の要望であればそれぞれの専門モデルへ渡します。一方、苦情の問い合わせについては複雑さのスコアと確信度を追加で確認し、複雑すぎる場合や確信度が低いケースのみ人へエスカレーションし、比較的単純なものは苦情対応用のモデルへ渡す制御が行われます。
ここで重要なのは、ひとつの大きなAIにあらゆる処理を任せるのではなく、最初の意図判定を行った上で、確実な処理は通常のコードで実行し、判断がつかないものは最初から人へ戻すという役割分担です。なお、公式資料に掲載されている確信度0.5といった数値はあくまでサンプルコード上の閾値であり、日本語の実際の業務でそのまま適用できる保証ではありません。取り扱う業務の重要度やリスクに応じて、どこまでをシステムで扱い、どこからを人に委ねるかを個別に調整する必要があります。
「届いた部品が違う」中小企業の問い合わせ例で考える判定設計
この考え方を中小企業の現場に当てはめて考えてみます。たとえば、製造業や機器販売の会社に「昨日届いた部品が注文内容と違っており、明日の現場作業でどうしても必要です」という問い合わせが入った場面を想定してみます。この文面には、「納品された商品に不一致がある」という手続き上の問題と、「明日の作業に間に合わせる必要がある」という時間的な切迫性の2つの要素が含まれています。
これを単一のキーワードで処理しようとすると、納品トラブルであることは拾えても、締め切りが迫っていることを見落として通常の返品対応キューに並べてしまう可能性があります。Jevのような仕組みを利用する場合、ひとつの文章に対して2つの独立した判定を同時に行う設計が適しています。1つ目は問い合わせの種類を判別するChoiceで、「注文内容の不一致」「商品の仕様確認」「見積依頼」などの選択肢から最も近いものを選びます。2つ目は緊急度を判別するNoulで、「期限が明示されており早急な対応が必要か」という問いに対してはい・いいえの確率を算出します。
ただし、この判定結果が出たからといって、いきなり自動返信を送ったり再発送の手続きを走らせたりするのは危険です。初期の段階では、判定結果を既存の問い合わせ管理画面に「推定カテゴリ:誤配送の可能性(高)」「緊急度:高」といったラベル候補として表示する運用にとどめるのが現実的です。実際の仕分けは人間の担当者が行い、AIが提示したラベルと人の判断がどれくらい一致しているかを一定期間観察します。文面の中に複数の要望が含まれている場合や、確信度が低い場合には、無理に分類せず「要確認」として人のトレイへ残す制御をコード側で入れておくことで、業務の混乱を防ぎながら実用性を検証できます。
開発や社内業務へ広げる:根拠資料の照合と検索結果の絞り込み
問い合わせの振り分けで活用した「小さな意味判断」は、業務システム内の別の場面や社内開発でも応用できます。代表的な応用のひとつが、AIが作成した回答文と社内マニュアルなどの根拠資料が正しく一致しているかを検証する処理です。
TypeSafe社が公開している引用検査のクックブックでは、回答文に含まれる引用箇所が元の文書に実在するか、またその文脈が主張を正しく支持しているかを判定する2段階の検証手順が示されています。引用文がある場合は、空白や引用符を正規化した上で元文書と文字列照合を行い、一致が見つからない場合はサンプル実装上「架空の引用」として扱います。ただしこの照合は完全一致を基準とするため、一部の省略やわずかな言い換えでも不一致と判定される制約があります。照合で一致した箇所の文脈や、引用文を持たず特定の節だけを指定しているケースでは、対象の節を直接取り出してJevのChoiceに渡し、「主張を支持しているか」「矛盾しているか」「何も言及していないか」を判定します。決定的な照合と文脈の意味判定を切り分けることで、検査全体の信頼性を高める設計です。
もうひとつの応用は、社内文書や過去の対応履歴を検索する際の関連度選別です。一般的なキーワード検索や類似度検索では、言葉の表面的な近さから無関係なマニュアルが多数ヒットすることがあります。こうした検索において、利用者の既存の閲覧権限でアクセスが許可されている候補をあらかじめ取得した上で、「この問い合わせの解決に必要な記述が含まれているか」をJevで短くスコアリングし、関係の薄い候補を削ぎ落とす構成が考えられます。Jev自体が権限管理を行うわけではないため、選別後も原典資料へのアクセス制限を維持したまま担当者や後段のシステムへ渡す設計が必要です。公式のユースケース一覧でも、検索結果の再順位付けや規約違反の検査など、限定的な判断を組み合わせる活用領域が多数挙げられています。
任せない処理の切り分けと、結果の保存設計
Jevを活用する上で強く意識すべきなのは、モデルに任せるべき処理と、プログラムや人間が担当すべき処理の境界線です。Jev 1.13の特性と注意点に関する公式解説では、このモデルが日常的な意味理解や分類に優れている一方で、苦手とする領域が明確に示されています。
たとえば、文字数のカウントや出現回数の計算、金額の足し算引き算といった算術処理は、jev-1.13に任せても正確性を安定して期待することはできません。そのため、こうした計数や数学的処理はモデルではなくプログラムコード側で実装することが推奨されています。また、2つの日付のどちらが先か、あるいは特定の期間内に収まっているかといった日時の比較も、モデルではなくプログラムコード側で日付型に変換して比較すべき領域です。さらに、無関係な情報が大量に含まれる長い文章をそのまま渡すと判定精度が低下するため、あらかじめプログラム側で必要な項目だけを抽出して渡す工夫が求められます。曖昧な指示や敵対的な入力に対しても影響を受ける可能性があるため、判断基準の定義は厳密に行う必要があります。
システム開発の観点では、判定結果の保存設計も重要です。問い合わせの入力内容、参照した根拠資料、そしてプロンプトなどの判定条件が変更されていない場合に限り、過去にAPIから返ってきた出力結果を自社のデータベースから再利用する設計案が考えられます。これはJevの標準機能として自動提供されるものではなく、開発側が自社システムで実装する制御です。問い合わせ本文が変わった場合はもちろん、参照している社内マニュアルなどの根拠資料が改訂されたり判定ルールが更新されたりした際にも、保存結果を無効化して再評価を行う仕組みにすることで、古い情報に基づく誤判定を防ぎつつAPIの呼び出しコストを抑えられます。
中小企業での導入条件と、デノフによる既存システムの連携相談
社内の問い合わせ窓口にこうした仕組みを取り入れるべきかどうかは、現在の業務規模によって異なります。1日に届く問い合わせが数件程度であったり、専用のフォームで項目があらかじめ厳密に分かれていたりする現場であれば、無理に新しいAPI連携を進める前に、まずは既存のメールフィルタや担当者による直接確認で対応できないかを先に検討することが考えられます。価値が生まれやすいのは、自由記述の問い合わせが一定量届き、担当者が文面を読み込む作業に時間を取られている環境や、過去の対応資料を探す手間に課題を感じている場面です。
また、既存の問い合わせフォームや管理ツールにAIの判定機能を組み込む作業は、ツール上の設定画面を操作するだけで完了するとは限りません。判定結果を画面のどこに表示し、確信度が低い場合に誰へ差し戻すかといった運用ルールの整理は業務側で決める必要があります。その上で、利用しているシステムの標準機能や連携機能でどこまで設定できるかを確認し、APIの呼び出しや例外処理が不足する場合にはじめて個別のシステム開発で補うという切り分けが現実的です。導入しただけで自動的に業務が完結するわけではなく、自社の体制に合わせた地道な設計が欠かせません。
Web・システム開発やAI活用支援を手がけるデノフでは、特定のAI製品の導入を一律に勧めるのではなく、現在運用されている問い合わせ窓口や社内ツールの状況を伺い、どこから手をつけるべきかの業務整理からご相談を承っています。公式のデノフのサービス案内でもご紹介している通り、既存の業務システムへの機能追加や外部APIとの連携開発、実務に合わせた自動化の仕組みづくりを一貫して支援しています。自社の問い合わせ対応でどの部分に自動判定が使えそうか、あるいは既存ツールの改修で対応できるかといった段階から、無理のない具体的な連携範囲を一緒に整理することが可能です。