スナップショット復元による起動時間の平準化
AWSは2026年9月18日、Amazon Bedrock AgentCoreのサーバーレスmicroVM実行基盤における新世代ランタイム「AgentCore Runtime V2」の提供開始を発表しました。公式発表のAWS What's Newの案内によると、従来の起動方式を刷新し、コンテナイメージのサイズや同時実行数に左右されにくい安定した起動時間の実現を目指しています。
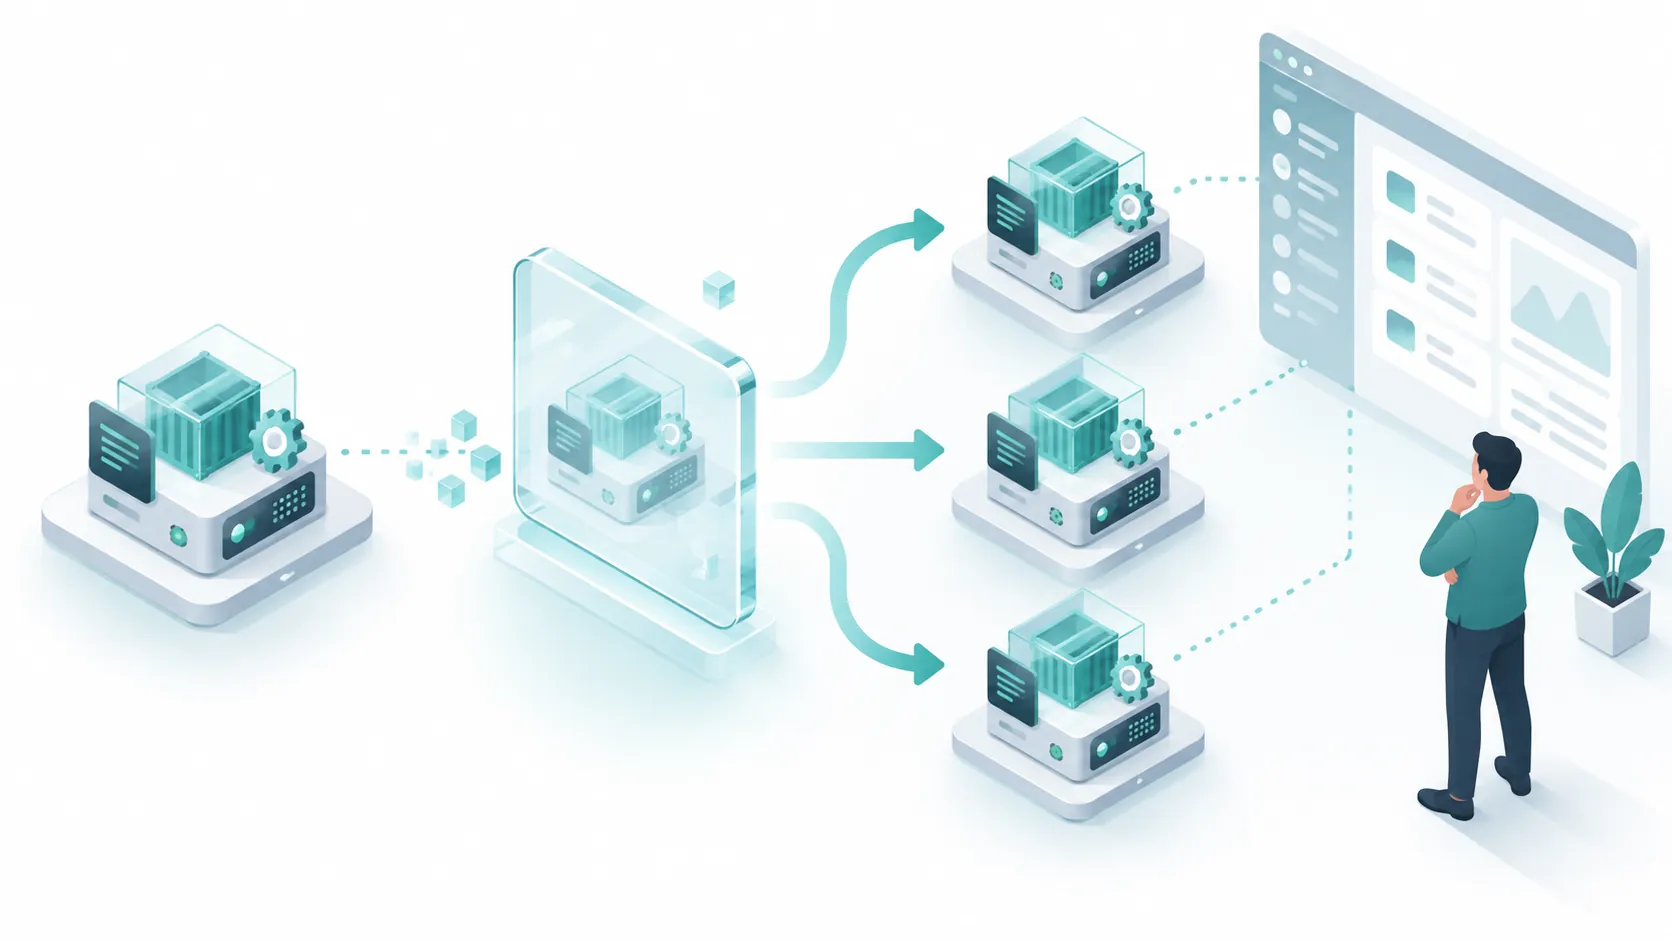
この仕組みについて、技術解説が掲載されたAWS Machine Learning Blogの記事では、初回起動時のオーバーヘッドを抑える工夫が説明されています。新Runtimeのインスタンスを作成または更新すると、システムがコンテナを起動して正常状態の応答を確認した段階で、実行環境のスナップショットを取得します。静的な設定取得や初期化処理をあらかじめ完了させた状態のスナップショットを保持し、以降の新しいインスタンスはこのスナップショットを復元して起動するため、ゼロから起動シーケンスを繰り返す必要がなくなります。
AWSが公表した測定値と実業務における評価の前提
AWSの自社試験では、200MBから2GBのコンテナイメージにおいて、コールドスタート時のP75(全体の75パーセントが収まる値)が1.9秒から2.0秒を記録したと報告されています。旧世代であるV1の測定値が5.4秒から約30秒だったことと比較して、起動のばらつきが抑えられている点が強調されています。
ただし、この数値を自社の業務システムへそのまま当てはめることはできません。AWSの試験環境は、入力をそのまま返すだけで言語モデルも外部ツールも呼び出さない「echo agent」を用いて測定されています。測定経路は、us-west-2のEC2インスタンス上のPythonクライアントからboto3 SDKを用い、VPCピアリングを介さずに公衆インターネット経由でus-east-1のエージェントへ呼び出したものです。AWSは、新旧両バージョンおよび5種類のイメージサイズを対象に、既定のアカウントクォータ内で各エージェントへ5,000回のコールド呼び出しを実施したと説明しています。したがって、報告された数値にはリージョン間の往復通信時間が含まれている一方で、業務処理そのものの時間は含まれていません。
AWSの技術解説では、本番エージェントで利用者が体感する実時間の多くはエージェント自身の処理ループやモデル呼び出しによるものであり、実行基盤の起動準備時間とエージェント自身の処理時間は区別して捉える必要があると説明されています。これに加え、実業務のエージェントでは業務構成に応じて社内データベースや外部APIの応答待ちなども発生し得ます。自社業務へ適用する際は、利用者の操作から初回応答までの全体時間の中で、基盤の起動待ちやモデル処理、外部連携がそれぞれどの程度の比重を占めているかを切り分けて測定することが重要です。
セッション中のメモリ回収と課金条件の確認
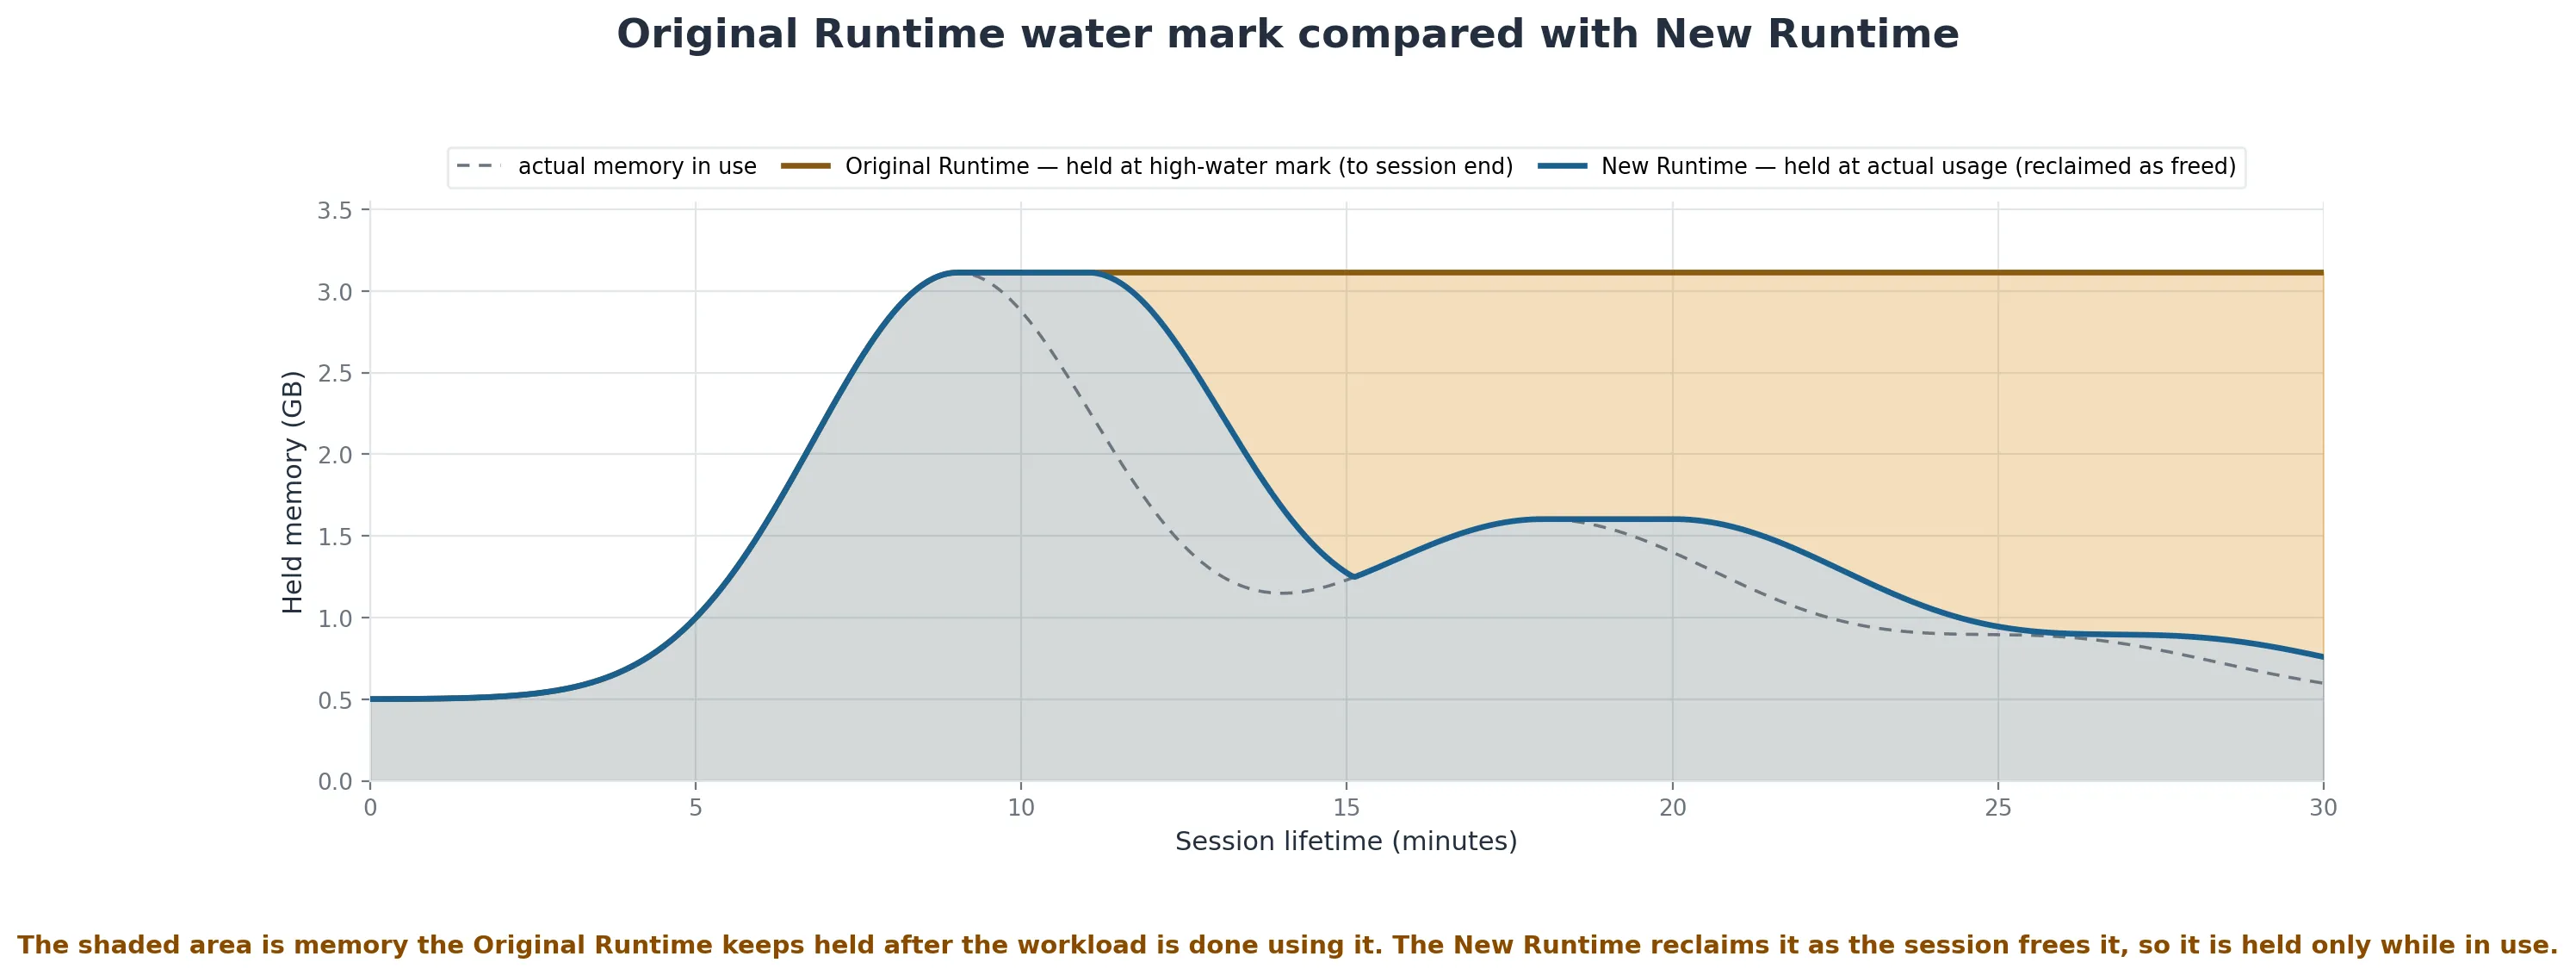
V2のもう一つの特徴は、動的なメモリ管理です。セッション開始時には小さなメモリプロファイルで起動し、ワークロードの負荷に応じてオンデマンドでメモリを割り当てます。さらに、セッション中に不要になったメモリは終了時まで保持されず、解放される設計となっています。
2026年9月21日に確認したAmazon Bedrock AgentCoreの料金ページによると、Runtime V2におけるアイドルメモリは120秒後に自動回収される仕様です。ただし、この回収仕様があるからといって、一律に利用料金が下がるとは限りません。Runtime microVMsの従量課金単価を確認すると、V1がCPUあたり0.0895米ドル/vCPU-hour、メモリあたり0.00945米ドル/GB-hourであるのに対し、V2の従量単価はCPUあたり0.1276米ドル/vCPU-hour、メモリあたり0.0169米ドル/GB-hourと、単位時間あたりの単価そのものは高く設定されています。なお、取得本文の料金表からは適用リージョンが特定できないため、実際の検討にあたっては対象リージョンの最新料金を確認した上で試算する必要があります。
課金計算は実際のCPUおよびメモリ消費量に基づく秒単位(最低1秒)で行われ、課金対象期間にはmicroVMの準備完了から初期化、処理、アイドル期間、セッション終了までが含まれます。アイドル期間全体が無課金になるわけではなく、I/O待機中にCPU消費がゼロにスケールする一方、メモリは120秒経過後に自動回収されるというように資源ごとに条件が異なります。また、128MBの最低メモリ課金やシステムオーバーヘッドが適用され、コンテナ配置に必要なECRストレージ費用やネットワーク転送料金も別個に発生します。そのため、移行によって費用が削減されるかを評価するには、ピークメモリ量だけでなく、セッション全体を通じたCPUとメモリそれぞれの使用量の時間推移を実測して試算することが不可欠です。
業務システムへの組み込みに向けた検証アプローチ
例えば、国内企業の受注管理画面において、過去の注文履歴と社内マニュアルを参照しながら問い合わせ回答案を作成する社内向けエージェントを想定してみます。このような対話型エージェントでは、画面を開いた瞬間の起動待ち、注文管理APIからのデータ取得、LLMによるテキスト生成という複数の処理が連続して発生します。
V2の提供リージョンには東京リージョン(ap-northeast-1)が含まれており、Runtimeの作成または更新時に設定パラメータのplatformVersionを「V2」に指定することで利用できます。まずはテスト環境において、現在のV1と新世代のV2を並行させ、起動にかかる時間と全体の応答時間を分離して記録することをおすすめします。あわせて、スナップショット復元後に認証情報や外部接続の再確立が意図通り行われるか、120秒のメモリ回収が業務フローにどう影響するかを確認することで、円滑な移行計画を立てることができます。
AIエージェントの業務連携と設計のご相談
AIエージェントを実行環境にデプロイするだけでなく、既存の問い合わせ管理や基幹システムと安全に連携させるには、処理の責務分担やデータ構造の整理が欠かせません。実行基盤の機能だけに依存せず、業務要件に合わせたアーキテクチャを設計することが安定稼働への近道です。
デノフでは、Webサイト・業務システムの設計・開発・運用保守サービスを通じて、業務フローの整理からAIを活用する業務の選定、ツール選定、現場に合わせた自動化の仕組み構築までを一貫して支援しています。既存システムとのAPI連携設計や運用手順の具体化をご検討の際は、デノフへのお問い合わせ窓口よりお気軽にご相談ください。