対話と専門処理を分担するエージェント設計
Shopifyが提供するEC向けAIアシスタント「Sidekick」では、店舗担当者との対話、作業計画の立案、ツール呼び出しをフロンティアモデルが担い、特定の集中した作業をサブエージェントへ渡す構成をとっています。同社が公表したオープンモデルを専門処理向けに学習させた技術記事によると、たとえば在庫が少ない商品を尋ねられた際、GraphQLサブエージェントがAPIスキーマやドキュメントを参照してクエリを生成・実行し、結果を返します。この処理は入出力のうち読み込むコンテキストの割合が高く、汎用モデルのAPI呼び出しをそのまま使い続けると負荷やコストが課題になります。そこで同社は、GraphQL処理専用にオープンモデル「Nemotron 3.5 Lightning」を追加学習させるアプローチをとりました。
モデル変更の前に評価基準と既存構成を磨く
注目すべきは、最初からモデルを置き換えるのではなく、まず既存構成を改善して比較の基準を引き上げた点です。Shopifyでは製品担当者が「網羅性」「実行」「回答品質」などを定めた評価基準であるルーブリックを作成し、LLM評価器を調整しました。Sidekickの継続学習ループを解説した資料にあるように、評価器はオフラインでの代理指標に過ぎないため、過去のA/Bテスト結果との照合や、特定の挙動を意図的に悪化させてスコアの反応を確かめるといった検証方法が提示されています。
その上で、既存のフロンティアモデル版エージェントに対して、プロンプト、ツール説明、制御フローの小さな修正を自動提案・評価し、スコアが向上した変更のみを採用しました。オープンモデルが超えるべき基準を、あらかじめ可能な限り高めておくという順序です。
失敗した会話をヒント付きで修復して学習データへ
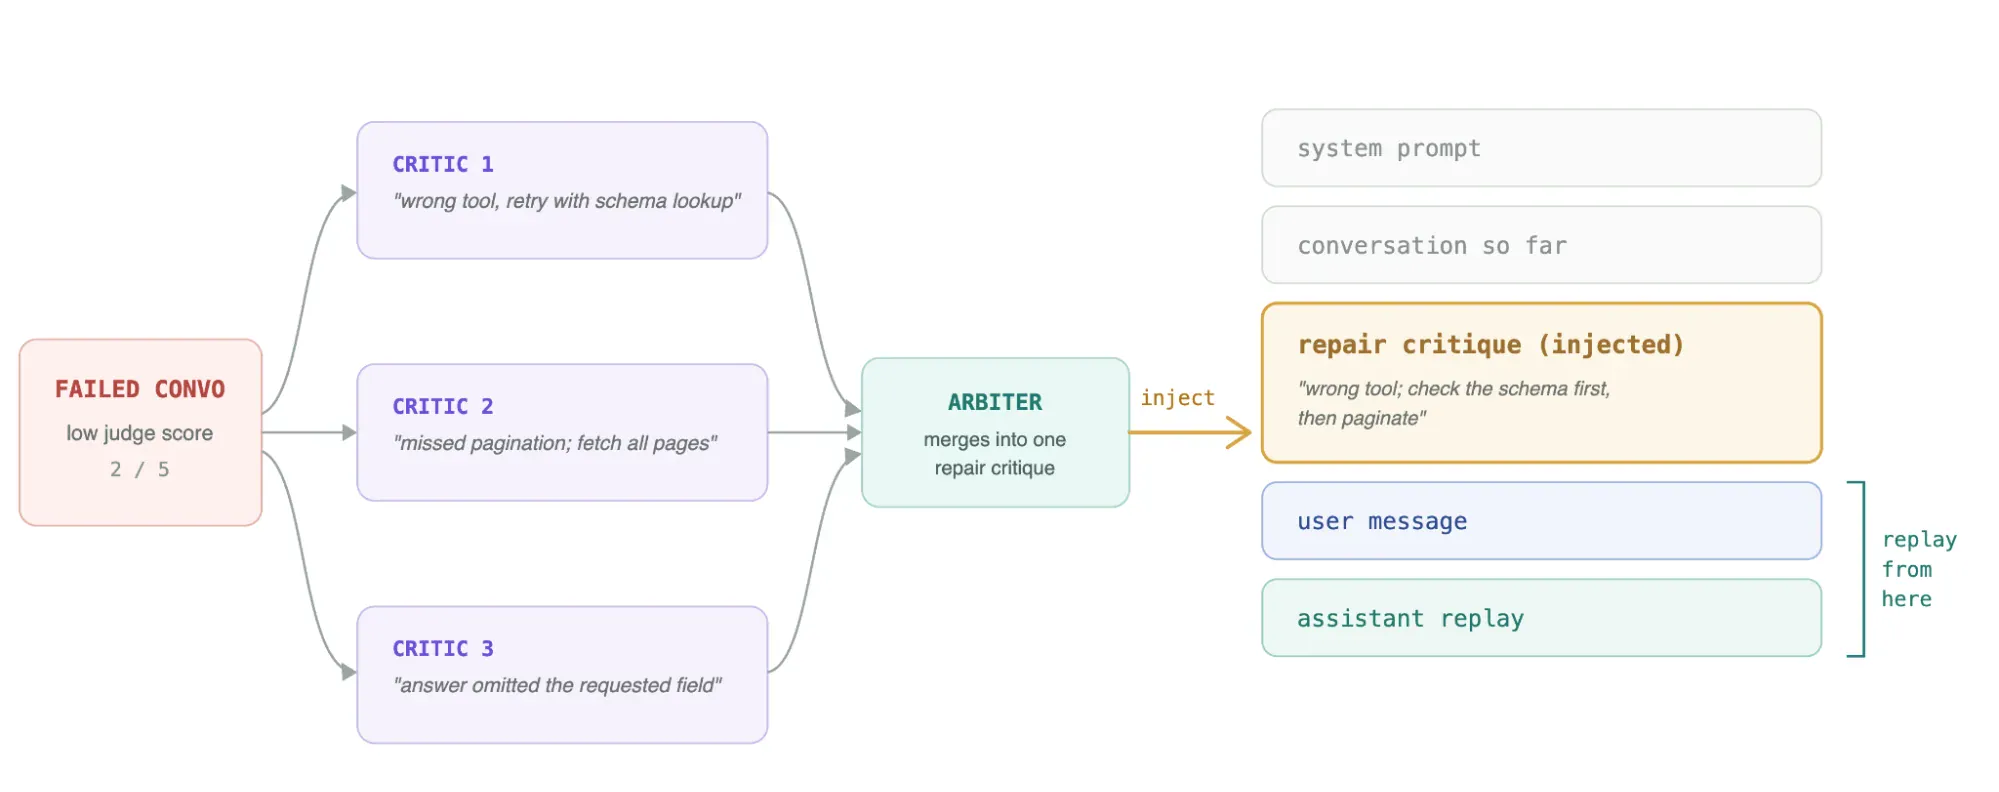
モデルの追加学習にあたっては、日々の本番トラフィックから低評価となった失敗例を収集し、修復する仕組みが用いられました。批評役となるフロンティアモデルが正解そのものではなく「ヒント」を作成し、模擬の店舗担当者が同じ店舗に対してリクエストを再実行します。再実行結果が評価器を通過した場合、付与したヒントを取り除き、会話を匿名化した上で学習データに追加します。
Shopifyの自己報告によれば、86回の夜間バッチで試行した失敗例のうち69%にあたる59,535件がこの修復工程でデータ化され、残りは人手で修正されました。6回のループと61,000件の修復例を経た結果、同社のGraphQL評価器によるスコアは、未調整の37.7から74.5へと向上しました。なお、比較対象としたフロンティアモデルのスコアは73です。このスコアは同社独自の評価尺度であり、一般的な正答率やモデル自体の性能を示すものではありません。
負荷試験による応答時間の比較と適用条件
Shopifyは本番導入の判断にあたり、顧客データの代わりに合成テキストを用いて本番トレースを再生する負荷試験ツール「AIPerf」を活用しました。この再生試験において、完全な応答が返るまでにかかった時間の中央値は、フロンティアモデルのAPIが6.50秒だったのに対し、追加学習したNemotronは0.87秒でした。また、最も遅い1%のリクエストでも約8倍速く完了したと報告されています。ただし、これは特定の再生試験環境での結果であり、本番の全利用者が体感する実測値とは区別する必要があります。
このように、入出力のスキーマが明確で、同じようなAPI呼び出しが大量に発生する処理は、専門モデルへの切り出しと追加学習を検討する候補になり得ます。ただし、この条件を満たす処理であっても直ちに有効と決まるわけではなく、適用先で同じ質問群を用いて比較しながら有効性を判断していくことが必要です。一方で、質問のバリエーションが定まらない業務や、利用頻度が限定的な処理に対して、最初から自社モデルの学習やGPU運用を前提にするのは負担が大きくなります。
国内業務における在庫照会を想定した小さな試行
国内企業の社内システムで同様の改善を検討する場合、いきなりモデルの追加学習に進むのではなく、まずは業務の整理と失敗パターンの把握から始めるのが現実的です。
たとえば国内卸売業における社内在庫照会の場面を仮定してみます。営業担当者がチャットで「特定商品の在庫状況」を尋ねた際、AIが既存の在庫管理APIを呼び出し、対象倉庫、在庫数の定義、更新時点を含めて回答する試作を考えます。実在の導入案件ではありませんが、業務設計を考える上で具体的な検討の単位です。
このとき最初に取り組むべきは、担当者同士で「正しい回答の条件」を照合し、曖昧な業務用語を洗い出すことです。在庫の定義が実在庫なのか引当可能数なのかといった基準を明確にした上で、利用が認められた例を使い、質問、API結果、担当者の修正理由をセットで記録していきます。誤りの原因がAPIのパラメータ指定ミスなのか、データ解釈の誤りなのか、質問側の不足なのかを切り分けることで、プロンプトの指示や接続処理の改善だけで解決できる範囲が見えてきます。同じ質問群で既存構成と改善案を比較し、確認作業の手間まで含めて採否を判断することが着実な進め方です。
既存システム連携と試作のご相談
AIを活用した業務効率化を進める上では、対話インターフェースの構築だけでなく、社内データベースや業務システムとの接続、そして回答精度を検証するための業務整理が欠かせません。
株式会社デノフでは、デノフのサービス案内でもご紹介している通り、業務の整理からAIを活用する業務の選定、ツール選定、導入後の定着までを一貫して支援しています。また、顧客管理や社内ツールなどの業務システム開発・API連携の知見をもとに、お客様の業務に合わせた自動化の仕組みづくりをお手伝いします。
対象業務の選定や既存APIとの接続方法の検討、回答例・失敗例を確認できる社内ツールの設計など、小規模な試作段階からのご相談も可能です。自社業務へのAI適用をご検討中の企業様は、ぜひデノフへの相談窓口よりお気軽にお問い合わせください。