機械学習モデルの学習やデータの前処理では、深層学習フレームワークや各種ライブラリを含むコンテナイメージのサイズが10GBを超えることも珍しくありません。これまでのAmazon SageMaker AIでは、ジョブの開始前にコンテナイメージ全体をインスタンスへダウンロードする必要があり、処理開始前の待機時間が発生していました。
今回発表された対応により、SOCIインデックスが付与されたイメージを使用することで、イメージ全体のダウンロード完了を待たずにコンテナが起動し、コードの実行が速やかに開始されるようになります。詳細はAWSによるSOCI対応の発表資料で確認できます。
必要なファイルから取得するSOCIの仕組みとフォールバック
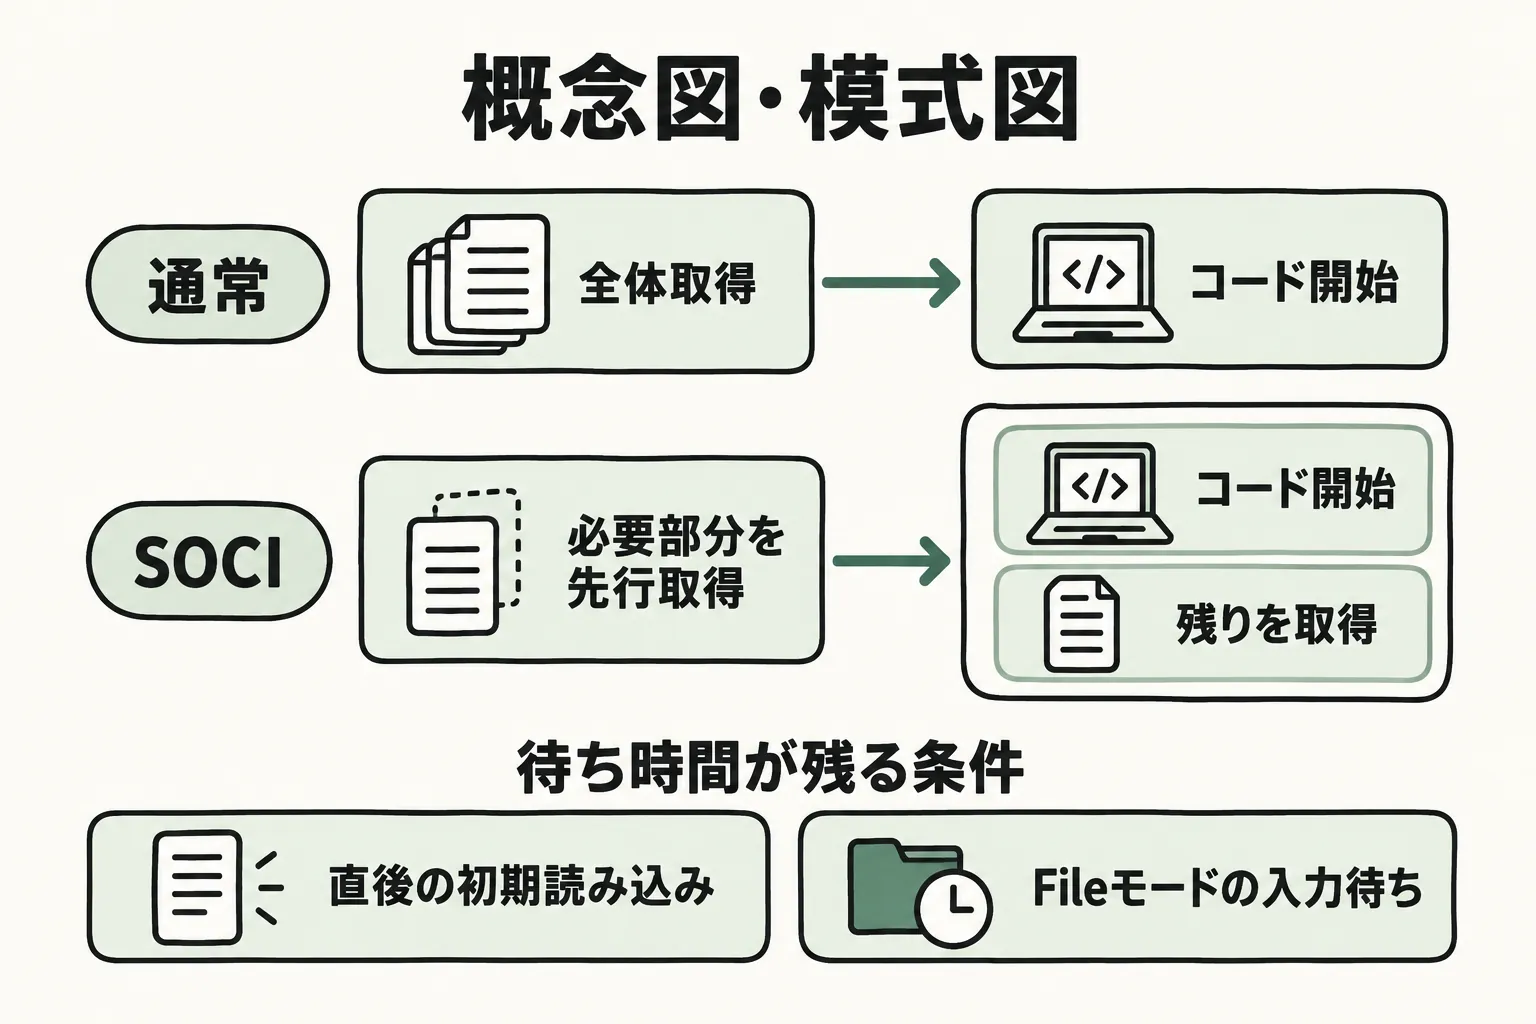
SOCI(Seekable OCI)は、コンテナイメージをオンデマンドで遅延読み込み(lazy loading)するための技術です。各レイヤー内のファイル位置をインデックス化しておくことで、コンテナ起動に必要な一部のファイルだけを先に取得し、残りのファイルはコードの実行中にバックグラウンドで取得します。
SageMaker AIはジョブ作成時に指定されたイメージのインデックスを自動で確認します。インデックスが存在しない場合や、何らかの理由でインデックスを利用できない場合でも、ジョブが失敗するわけではありません。通常のダウンロード処理へ自動的に切り替わり、そのままジョブが継続実行されます。
SOCIを適用するための条件と参照形式
既存のジョブでこの仕組みを利用するには、いくつかの運用上の前提条件を満たすことが重要です。学習ジョブの具体的な設定や注意点については、公式ドキュメントの学習ジョブにおけるSOCIインデックス付きイメージの利用手順にまとめられています。
主な適用条件は次の通りです。
- イメージの保管場所:Amazon ECRのプライベートリポジトリに配置されていること
- 参照方法:ダイジェスト参照(sha256指定)ではなく、タグ参照(repository:tag)で指定されていること
- インデックス形式:SOCI index v2形式が含まれていること
ダイジェスト参照で固定している場合や、SOCI index v1形式のインデックスでは遅延読み込みが機能せず、通常のダウンロード処理が行われます。AWSが提供するDeep Learning Container(DLC)では「-soci」というサフィックスが付いたタグが用意されており、これらを利用する場合はタグの切り替えだけで対応できます。独自イメージを利用している場合は、nerdctlなどのツールを用いてインデックスを作成し、ECRへ登録する手順が必要です。
待ち時間が別工程へ移るケースと前処理ジョブでの注意点
イメージ取得の工程が短縮されても、業務処理全体の完了時間が必ずしも同じ割合で短縮されるとは限りません。ファイルの読み込み自体が消えるわけではないため、次のようなケースでは注意が必要です。
まず、学習コードの開始直後に、イメージ内に同梱された大規模なモデルの重みファイルなどを一括で読み込む設計になっている場合です。この場合、コンテナ自体の起動は早くなりますが、初回ファイルアクセス時に読み込み待ちが発生するため、待機時間がダウンロード段階からコード実行の冒頭へ移動する形になります。
また、入力データの取得モードにも留意が必要です。公式ドキュメントの処理ジョブにおけるSOCIインデックス付きイメージの利用手順にあるように、処理ジョブで入力データの取得モード(S3InputMode)にFileを指定している場合、入力データ全体のダウンロード完了を待ってからスクリプトが実行されます。同様に、学習ジョブでもFile入力モードではデータセット全体のダウンロードを待つため、入力データが非常に大きい環境では、データ転送待ちがボトルネックとして残る可能性があります。
さらに、Apache Sparkやscikit-learnなどのSageMaker AIマネージド処理イメージには、現時点でSOCIインデックスがあらかじめ付与されていません。これらをベースに遅延読み込みを活用する場合は、該当コンテナをもとに独自イメージをビルドしてインデックスを付与する構成を検討することになります。SOCI環境はcontainerdベースのランタイムで動作するため、コード内にDocker固有のファイル判定(/.dockerenvなど)が含まれていないかといった互換性の確認も併せて求められます。
自社の処理に導入する際の進め方と検証のポイント
デノフでは、こうした新しい仕組みを既存のデータ基盤や機械学習基盤へ取り入れる際、いきなり全体の設定を変更するのではなく、効果が期待できるジョブを限定して比較検証を行うことが現実的だと考えています。
たとえば、日次で売上データの前処理と需要予測モデルの学習を行っている小売企業の業務を仮定します。まずは比較的イメージサイズが大きく、起動頻度が高いジョブを1つ選定することが大切です。その上で、現在の参照方式がタグかダイジェストかを確認し、起動スクリプトの冒頭でどのようなファイルアクセスを行っているかを整理します。
検証時には、同じ入力データとパラメータを用いて、従来のイメージ指定とSOCIインデックス付きイメージ指定の両方でジョブを実行します。比較すべき指標は「コード実行が開始されるまでの時間」だけでなく、「処理全体が完了するまでの時間」と「生成された出力結果の一致」です。遅延読み込みによって処理中のファイル取得が学習ループの速度に悪影響を与えていないか、データ転送待ちが全体のボトルネックになっていないかを切り分けて評価することが重要です。
既存ジョブの切り分けやAI活用の進め方について
AIやデータ分析基盤の運用では、クラウドサービスの新しい機能を取り入れることで効率化が図れる一方、既存のビルド手順、配布ポリシー、データパイプラインとの兼ね合いを慎重に見極める必要があります。
株式会社デノフでは、Webシステムや業務システムの設計・開発・運用保守を手がけており、業務の整理からAIを活用する領域の選定、ツールの導入支援までを行っています。詳しくはデノフのサービス案内をご覧ください。
既存の学習・前処理ジョブにおける待機時間のボトルネック調査や、改修範囲の整理、自社業務に合わせた自動化の進め方についてお悩みの際は、デノフへの相談窓口よりお気軽にご相談ください。現状の構成や業務の流れを丁寧に確認しながら、現実的な進め方を一緒に整理します。