小型マルチモーダルモデルの登場と8GB VRAMという選択肢
社内システムや現場業務へのAI組み込みでは、必要な機能を満たしながら、自社の運用環境やインフラ費用に収まるモデル規模を選ぶことが欠かせません。このモデル選定を巡って、注目すべき仕様が公開されました。
AWSは2026年9月14日、Mistral AIが開発したMinistral-3-3B-Instruct-2512およびMinistral-3-8B-Instruct-2512がAmazon SageMaker JumpStartで利用可能になったと発表しました。詳細はAWSのMinistral 3提供開始に関する発表で確認できます。
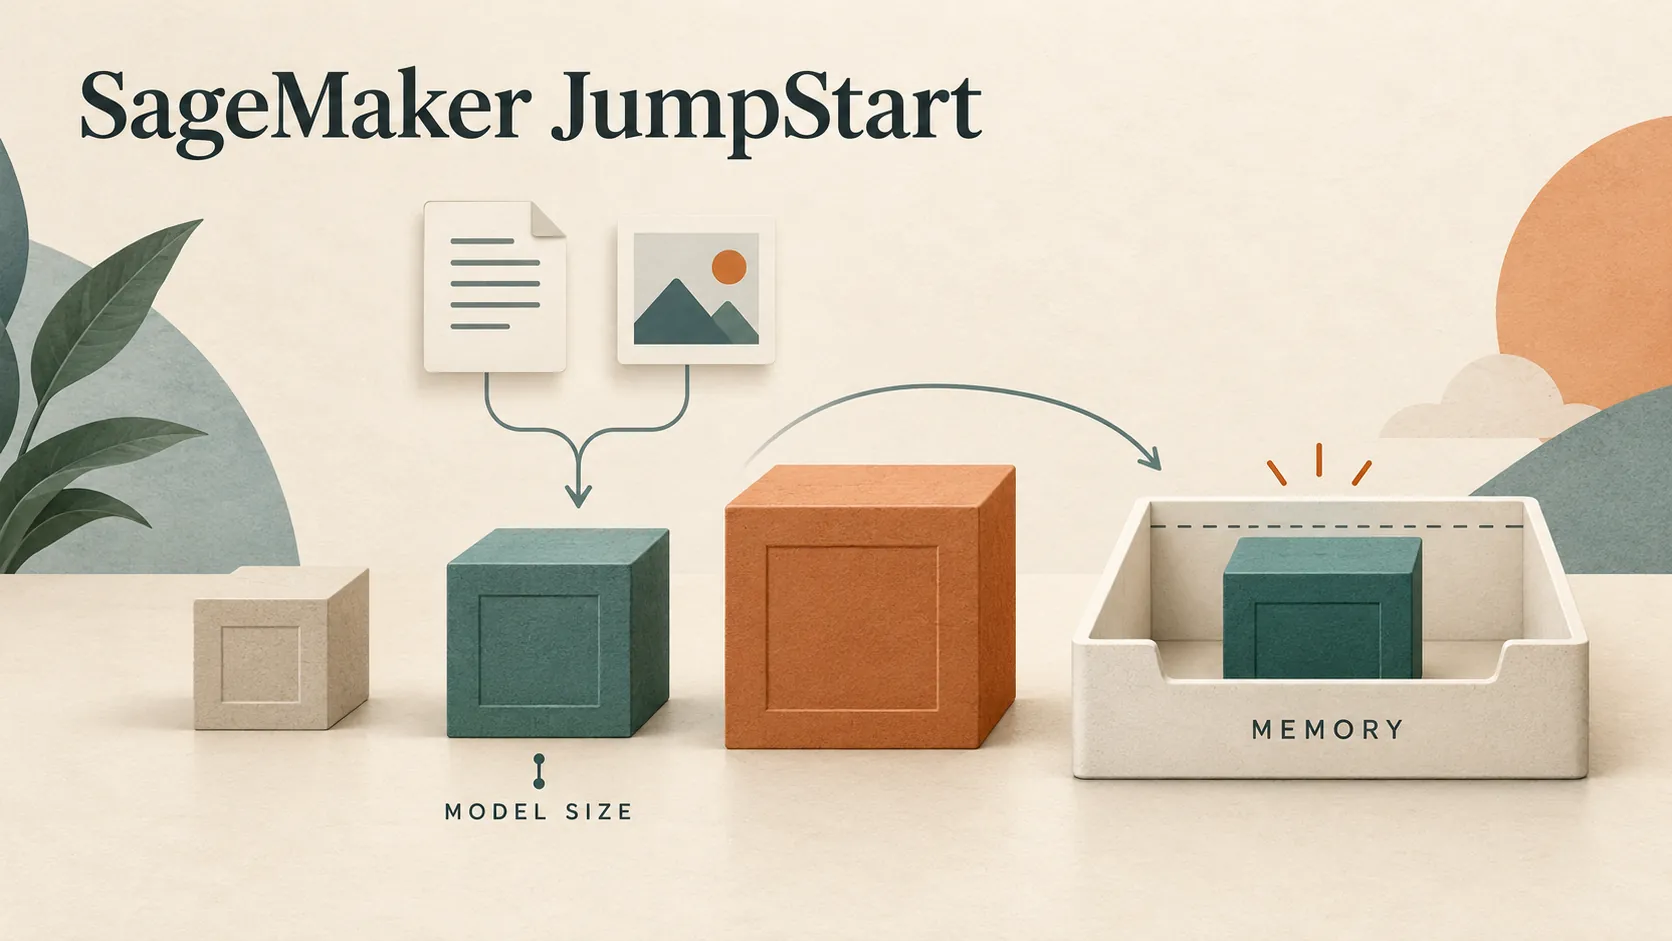
発表資料によると、Ministral-3-3B-Instruct-2512は3.4Bの言語モデルと0.4Bの視覚エンコーダで構成され、FP8精度において8GBのVRAMに収まるよう設計されています。小型でありながら、256Kトークンのコンテキストウィンドウ、画像分析、日本語を含む多言語での指示追従、さらに構造化JSON出力を伴うネイティブ関数呼び出しに対応し、ライセンスはApache 2.0とされています。また、同時に提供されたMinistral-3-8B-Instruct-2512は8.4Bの言語モデルと0.4Bの視覚エンコーダを備え、FP8で12GBのVRAMを必要とし、効率的な推論を行うためのアテンション機構を採用しています。
より大きなモデルを量子化で抑えるアプローチ
業務で扱うタスクが複雑で、より大きなパラメータを持つモデルが必要になる場合でも、実行環境の制約を緩和する選択肢が示されています。同じく2026年9月14日には、Google DeepMindのGemma 4モデルに関する発表も行われました。内容はAWSのGemma 4提供開始に関する発表にまとめられています。
この発表で示されたGemma-4-31B-IT-NVFP4は、NVIDIAのModelOptフレームワークを用いて4-bit FP4精度に量子化されたモデルです。これにより、メモリ使用量をベースモデルから約68%削減した約18.5GBに抑えられています。AWSのモデル説明では、元品質の97〜99%を維持しながら約2.5倍の推論速度を達成したと報告されています。ただし、この数値はベンダーが示したモデル仕様上の自己報告であり、個別の実業務データを用いた測定結果ではない点に留意する必要があります。
業務要件から逆算するモデル規模と実行基盤
こうした公式仕様を踏まえると、AI導入の検討では「どのモデルが高性能か」を単独で比較するのではなく、現場の業務フローが求める入出力形式と、用意できる実行環境のメモリ容量を突き合わせて絞り込む作業が重要になります。
実在の案件ではない仮定例として、現場で撮影された写真と日本語の点検報告文をもとに、既存の点検管理システムへデータを登録する業務を考えてみます。この場合、画像とテキストを同時に受け付けるマルチモーダル対応であることや、既存システムのAPIやデータベースが正しく受け取れる構造化JSONを出力できることが必須の要件となります。その要件を満たした上で、FP8精度において8GBや12GBのVRAMに収まるという小型モデルの公式仕様を前提にできるのか、実行環境全体に必要なメモリは別途確認しつつ、より高度な推論を求めて約18.5GBの量子化モデルを視野に入れるのかを検討します。
自社で検討を進める際は、まずAIに渡すデータが画像・文書・音声のどれにあたるかを棚卸しし、出力が自由文でよいのか構造化データであるべきかを切り分けることから着手できます。同時に、現行のインフラで確保可能なメモリ制約を確認しておくことで、候補となるモデルの現実的な範囲が見えてきます。ただし、モデルの機能要件が合致しても、既存システムとの安全な通信経路や権限管理、例外発生時の処理フローなどは個別の設計が必要です。
導入に向けた検証設計とご相談
モデルの公式仕様は導入候補を絞り込む材料になりますが、実際の業務データにおける認識精度、応答の遅延、インフラ運用費用などは個別に検証しなければ判断できません。まずは限定された業務領域と評価用データを定め、小さく検証サイクルを回すことが確実な導入につながります。
デノフでは、対象業務の業務フローとAI処理範囲の整理や、既存システムとの連携要件の定義、候補モデルの検証観点の設計など、実装検討に向けた整理をお手伝いしています。詳しくはデノフのサービス案内をご覧いただき、具体的な課題の整理についてはデノフへの相談窓口よりお問い合わせください。