AIモデルの大規模な学習や微調整、夜間のデータ処理パイプラインを運用していると、需要が高まる時間帯に必要なGPUインスタンスが即座に確保できず、実行が遅延することがあります。従来の運用ではジョブ投入時に単一のインスタンスタイプを指定する必要があったため、容量不足が生じると長時間待機するか、手動で別の構成へ再実行する、あるいは複数の構成で並行してジョブを投げて監視・キャンセルを行うといった複雑な仕組みを独自に作り込む必要がありました。
こうした課題に対し、AWSは2026年9月15日、Amazon SageMaker AIの学習ジョブおよび処理ジョブにおいて、優先順位付きのインスタンスタイプリストを指定できる機能の提供開始を発表しました。詳細は公式発表のAmazon SageMaker AI now supports instance preference listsで案内されています。
優先順位付きリストから利用可能な構成を自動選択する仕組み
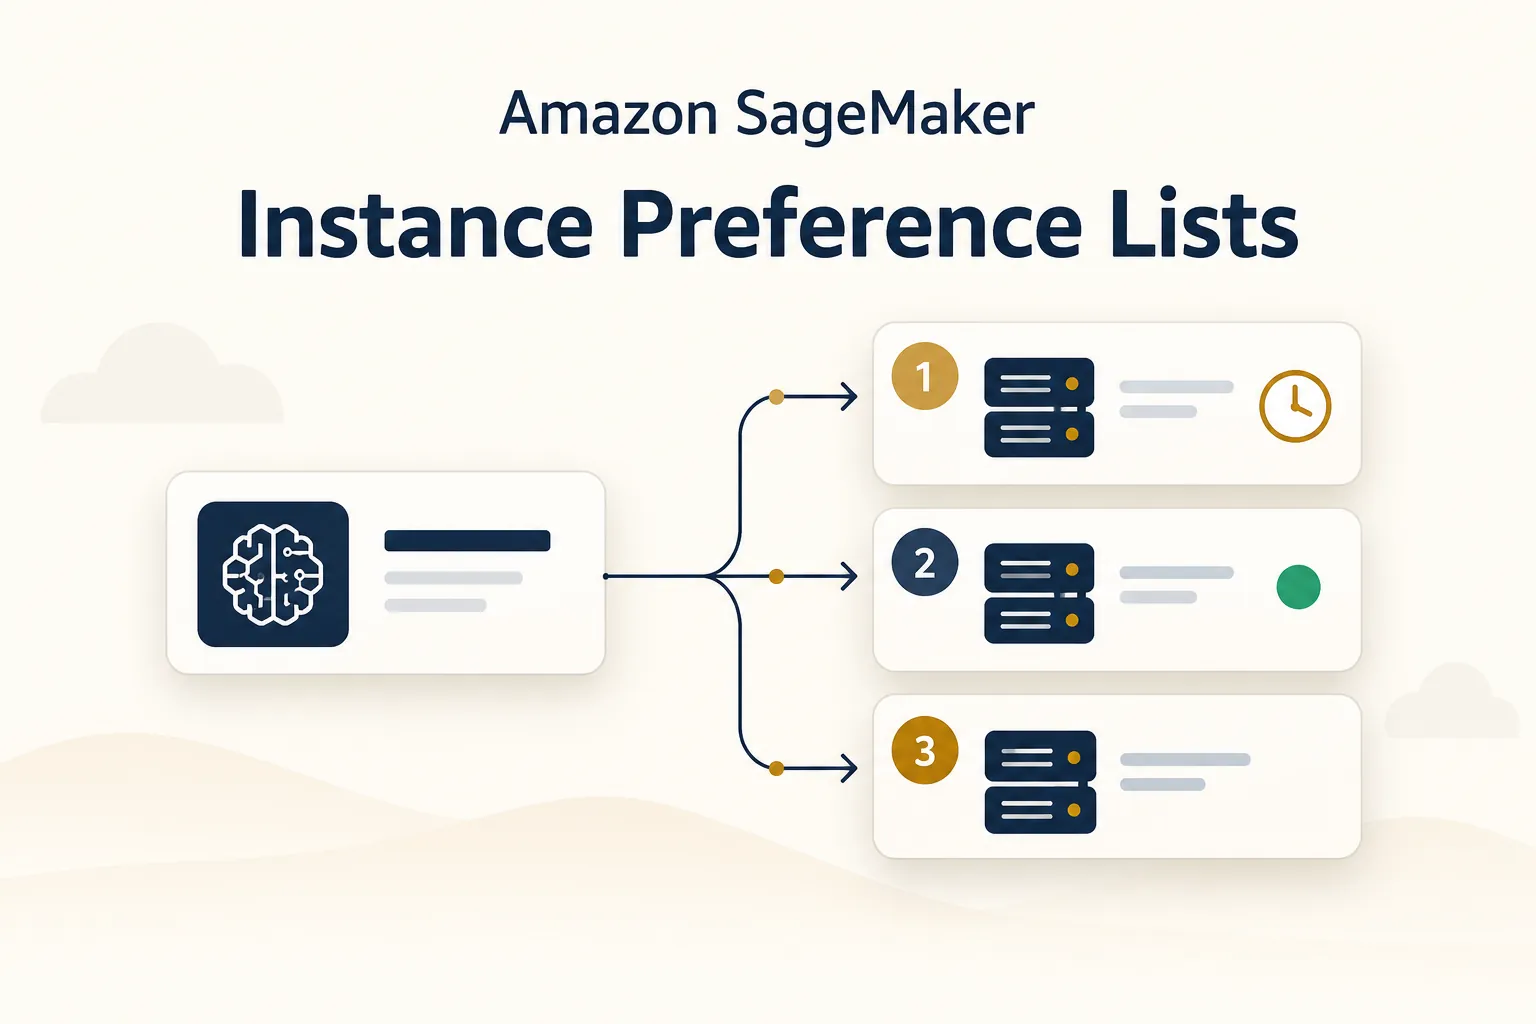
この機能では、ワークロードが許容できるインスタンスタイプと台数の組み合わせを、優先度を付けたリストとしてジョブ作成時に指定します。ジョブが投入されると、スケジューラが優先順位に沿って容量を確認し、利用可能な最初の構成で直ちにジョブを起動します。
公式技術ブログのAnnouncing instance preference lists for Amazon SageMaker AI training jobsによると、候補として指定できるインスタンスタイプは最大5件です。もし評価時点でどの候補にも空き容量がない場合、ジョブはイベント駆動型のキューに入り、容量が利用可能になった時点で自動的に再試行されます。
待機時間の上限は、MaxPendingTimeInSecondsパラメータで制御できます。この設定はリスト全体で試行を続ける合計時間を制限するものであり、個々のインスタンスタイプごとに個別に適用されるわけではありません。また、この上限設定が有効になるのはml.p系、ml.g系、ml.trn系といった加速コンピューティング(GPU等)のインスタンスタイプが候補に含まれる場合に限られ、CPUのみの構成では効かない点に注意が必要です。
導入前に確認すべき候補間の互換性と設定の違い
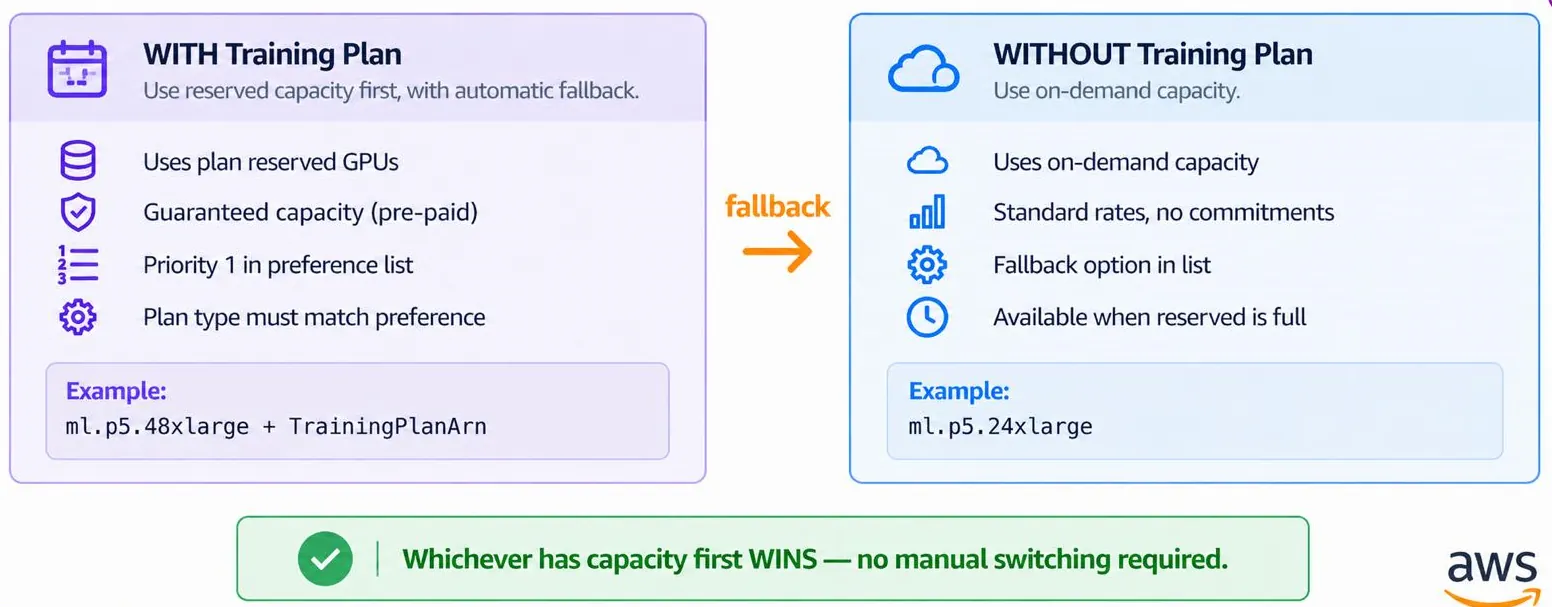
優先リストの導入によってジョブ開始までの待機短縮が期待できる一方で、事前の設計と検証が必要な条件も明確に示されています。
まず注意すべき点は、SageMaker AI自体は候補間の互換性検証を行わない点です。GPUアーキテクチャの違い、Elastic Fabric Adapter(EFA)の対応状況、ドライバやCUDAのバージョンなどが異なる構成を候補に含める場合、利用するコンテナやコードがすべての候補で正常に動作するかは利用者が事前に確認する必要があります。
また、ノードごとの計算能力が異なるインスタンスを混在させる場合は、候補ごとに台数を調整して全体の計算スループットを揃える工夫が求められます。例えば、処理能力の高いノード2台を第1希望とし、代替としてやや性能の異なるノード4台を指定するといった設計です。この場合、学習コード側がGPU数の変動に適応できるかも事前の検証対象になります。
さらに、容量の調達元に関する仕様差も把握しておく必要があります。学習ジョブでは予約容量であるFlexible Training Plan(FTP)を特定の候補に紐付け、予約枠を優先して使い切り時はオンデマンドへ切り替える構成が可能ですが、処理ジョブではTraining Plan統合がサポートされていません。
国内でのジョブ運用への応用と検討の手順
国内の事業者においても、例えば夜間に社内文書の分類・要約用モデルを定期再学習するような場面では、単一構成の空き待ちによる翌朝までの処理遅延が課題になり得ます。このようなジョブを柔軟なフォールバック設計へ移行するには、次のような段階を踏んで整理を進めることが現実的です。
まずは、現在固定されているインスタンスタイプに対し、同様の学習時間やリソース要件を満たせる代替構成が存在するかを洗い出します。次に、それらの候補構成で共通の学習コンテナや分散処理がそのまま動作するか、単体テスト環境で互換性を確認します。その上で、夜間パイプラインが許容できる最大待機時間を算定し、上限を超えて失敗した場合の通知先や翌朝の業務判断ルールを決めていきます。
クラウド側の機能で優先候補や待機上限を宣言できるようになっても、対象モデルでの実効性能、運用コスト、既存のワークフロー管理ツールとの連携方針については、個別要件に応じた判断が不可欠です。
既存ジョブの見直しと連携のご相談
AIモデルの学習や定期バッチ処理を単一のインフラ構成に依存させていると、容量不足時の運用負担が大きくなります。リトライ処理を複雑化させる前に、許容できる実行候補と待機条件を整理することが運用の安定化につながります。
株式会社デノフでは、AI導入に向けた業務整理や、既存システムとの連携範囲、実装・運用の確認項目の整理を支援しています。自社業務の技術的な整理についてはデノフのサービス案内をご確認の上、具体的な進め方のご相談はデノフへの相談窓口からお問い合わせください。