常時エンドポイントを置かないオフライン推論とG6eインスタンスの追加
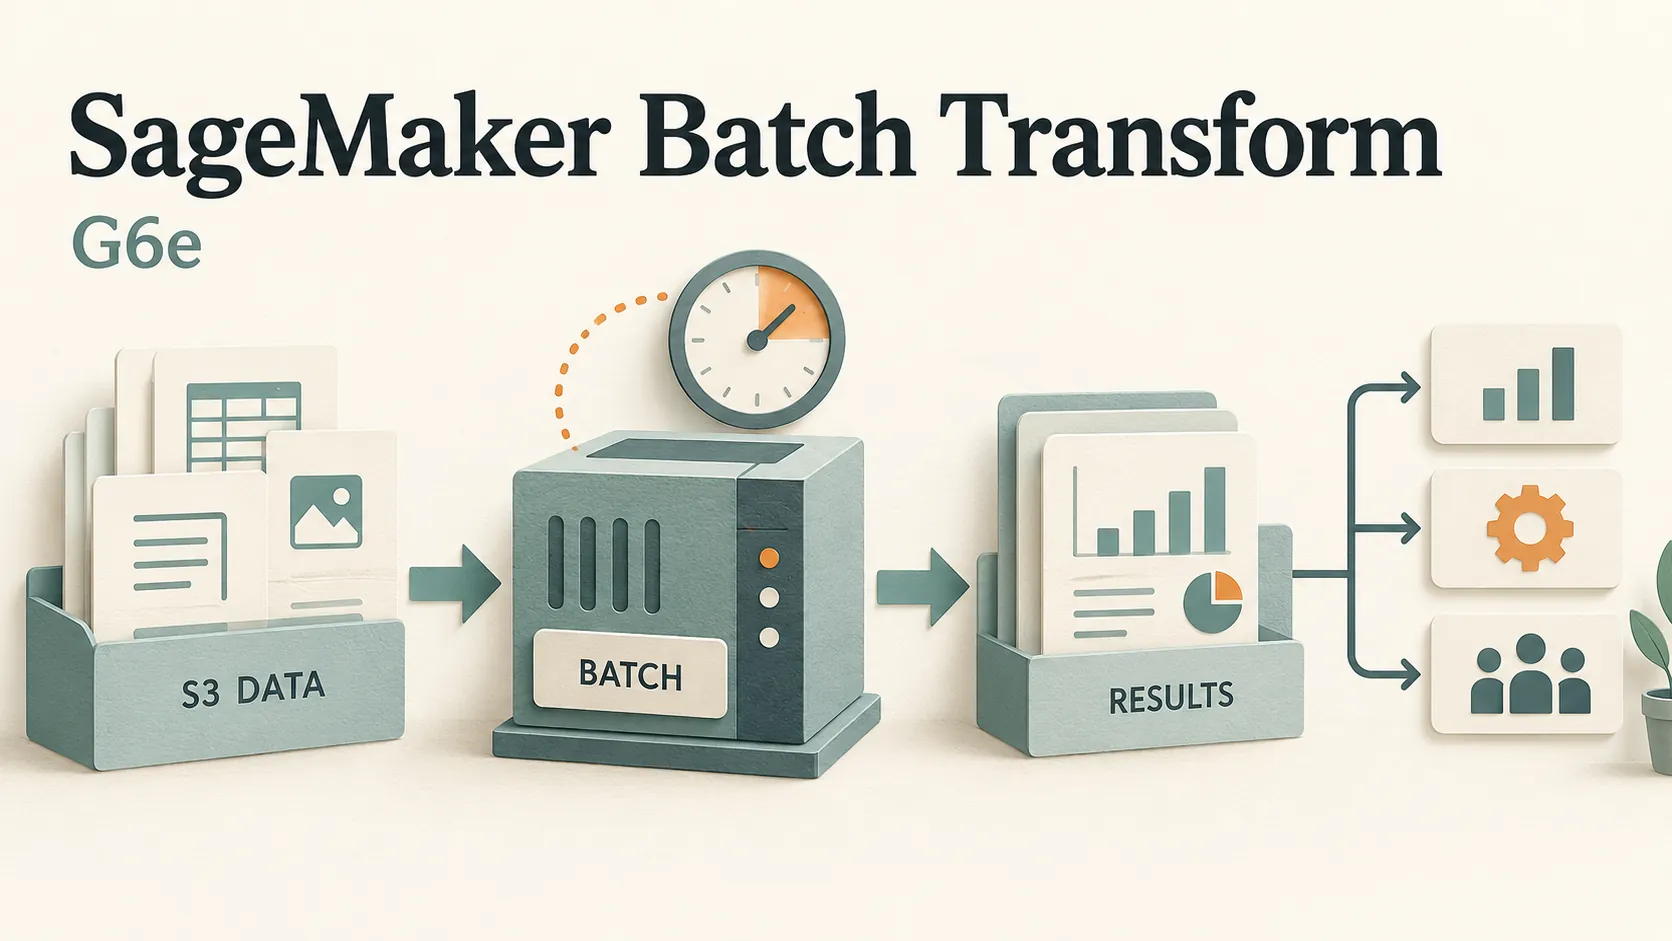
2026年9月4日、AWSはAmazon SageMaker AI Batch TransformにおいてAmazon EC2 G6eインスタンスのサポートを追加したと発表しました。公式発表のSageMaker AI Batch TransformのG6e対応案内によると、この機能はAmazon S3に保存されたデータセットに対して予測処理を実行するもので、常時稼働する永続的な推論エンドポイントを必要としない大規模データの処理に適していると説明されています。
今回利用可能になったEC2 G6eインスタンスは、GPU当たり48GBのメモリを持つNVIDIA L40S Tensor Core GPUを最大8基、そして第3世代のAMD EPYCプロセッサを搭載しています。大規模言語モデルや画像・動画・音声を生成する拡散モデルといった、GPU負荷の高いオフライン推論ワークロードを想定した構成です。
モデル要件とインスタンス構成の確認ポイント
一括推論でG6eを検討する場合、扱うモデルのサイズや処理量に合わせて適切なインスタンス規模を照合する必要があります。Amazon EC2 G6eインスタンスの詳細では、1基のGPUと48GBのGPUメモリを備える構成から、8基のGPUで合計384GBのGPUメモリ、192基のvCPU、最大1.536TBのシステムメモリ、最大7.6TBのローカルNVMe SSDストレージを備える構成まで、複数のインスタンスサイズが示されています。
ただし、導入にあたっては事前の条件確認が欠かせません。今回の発表時点でBatch Transform向けにG6eが利用できるリージョンは、米国東部(バージニア北部、オハイオ)、米国西部(オレゴン)、アジアパシフィック(ムンバイ、ハイデラバード)に指定されており、日本国内リージョンでの提供状況は発表資料からは確認できません。また、実際の処理時間や費用、個別モデルの動作性能はワークロードによって異なるため、実際のデータ要件に合わせた事前の検証が必要です。なお、ジョブの作成はAWS SDKやAWS CLI、CreateTransformJob APIを通じてml.g6eインスタンスタイプを指定して行います。
既存データ基盤を活かした定期処理の検討
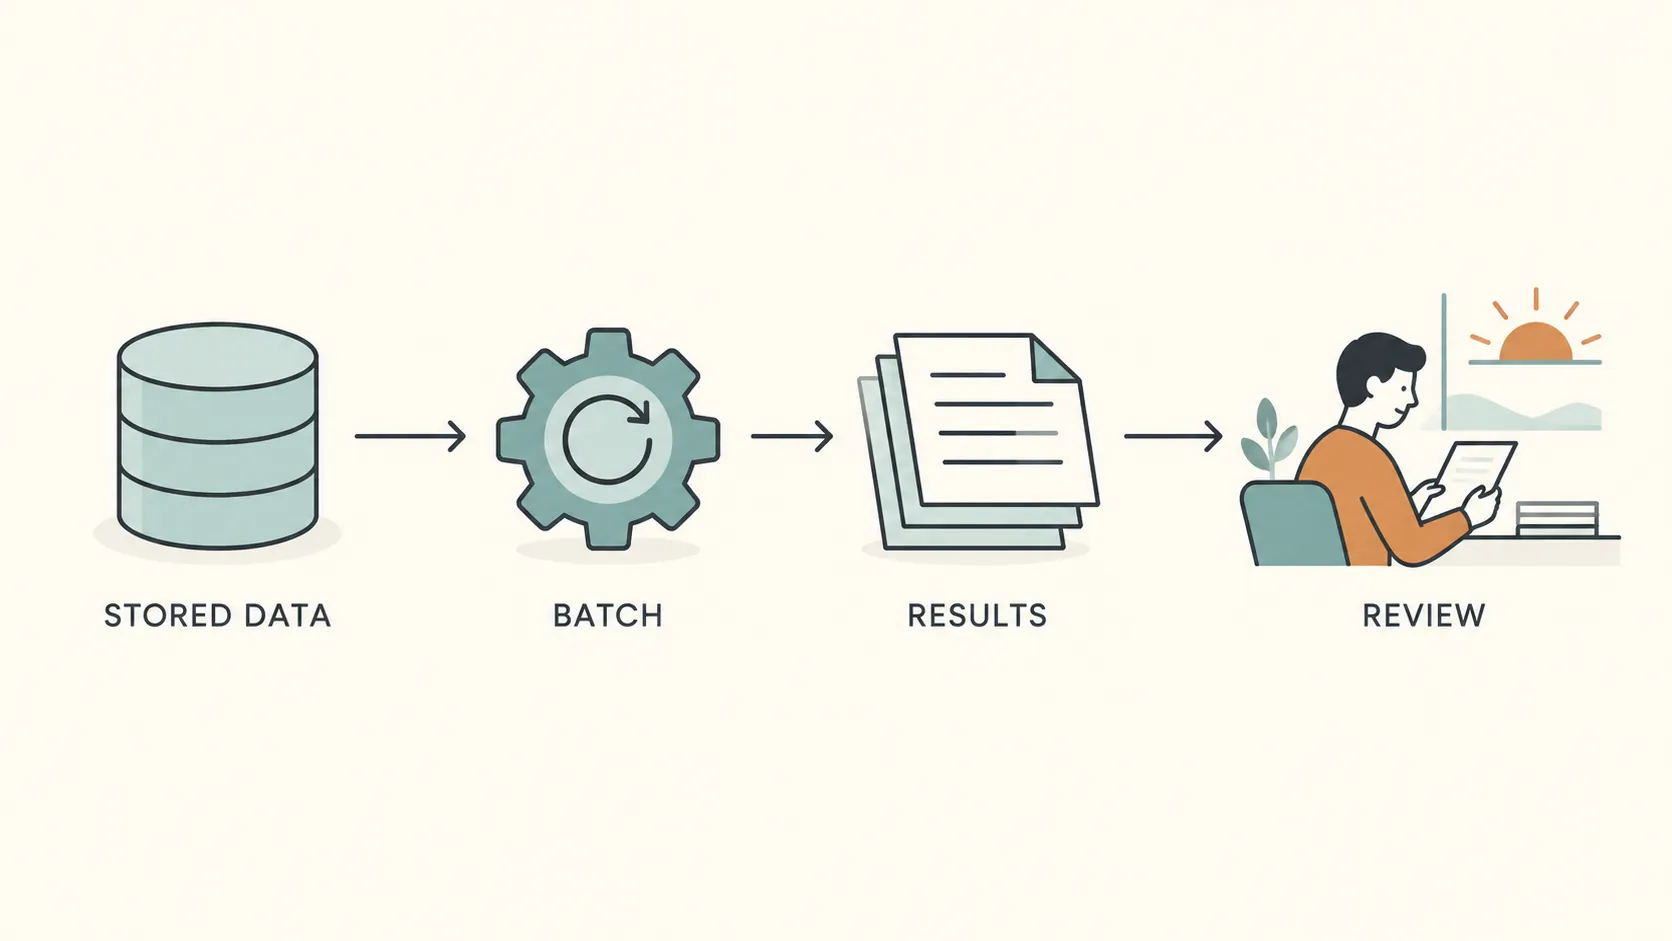
こうした一括推論の仕組みは、即時の応答を必要としない業務において、既存のデータ蓄積を活かした設計候補となります。実在の事例ではない一つの仮定例ですが、日々の運用でS3へ蓄積された問い合わせ履歴や画像資料を夜間や月次のタイミングでバッチ処理し、分類や抽出を行った結果を翌朝の確認業務へ引き渡すような構成が考えられます。
既存の業務システムと連携させる際には、まず対象業務がミリ秒単位の即時応答を求めているのか、定期的な一括処理で十分なのかを整理します。そのうえで、入力データの保管場所や形式、処理頻度、処理後の出力データをどの業務システムやデータベースへ戻すかといったデータフローを具体化していきます。
処理単位の整理とデータ連携のご相談
業務システムへのAI組み込みでは、常時稼働の基盤を前提にするだけでなく、既存のデータ更新頻度や利用目的に合わせた実行単位を見極めることが安定した運用につながります。デノフのサービス案内では、Webや業務システムの設計・開発とともに、AI導入対象業務の整理や既存システムとのデータ連携範囲の検討といった技術支援を提供しています。
蓄積された業務データを一括処理したいものの、即時処理とバッチ処理の切り分けに迷っている段階や、前後のデータ受け渡し仕様を整理したい場合は、デノフへの相談窓口よりご相談ください。業務フローに合わせた実行単位の整理や連携設計の具体化をお手伝いします。