サーバーレスのモデル調整でシーケンス長が指定可能に
AWSは2026年10月21日、Amazon SageMaker AIのサーバーレスモデルカスタマイズジョブにおいて、ハイパーパラメータとしてシーケンス長を設定できる機能を発表しました。これまでファインチューニングの各レシピではシーケンス長が固定されており、利用者が変更することはできませんでした。
この機能拡張により、短い質問回答のペアから複数ページにわたる文書まで、学習データの特性に応じて長さを調整できるようになりました。詳細はAWSによるシーケンス長設定の発表資料で案内されています。
シーケンス長は「入力と回答の合計トークン数」
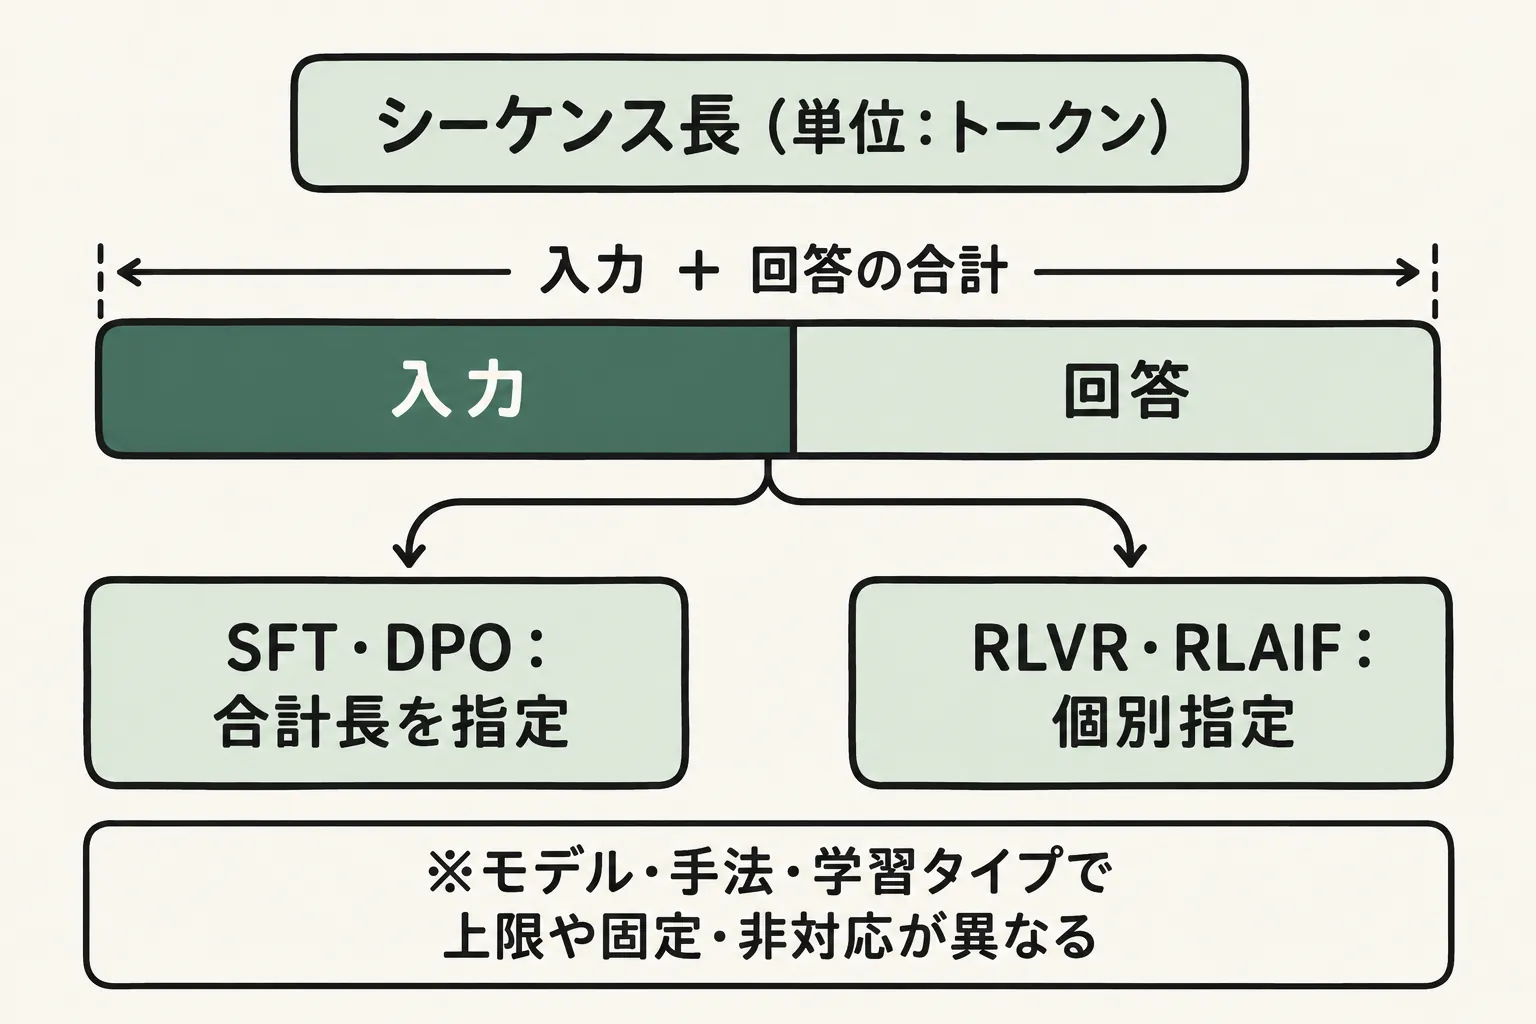
今回の機能を利用する上で押さえておきたいのが、シーケンス長の定義と設定方法です。SageMaker AI公式の対応シーケンス長仕様によると、シーケンス長とはプロンプトの長さと回答の長さを足し合わせた合計のトークン数を指します。
指定するパラメータは、選択する学習手法によって異なります。SFT(教師あり微調整)やDPOジョブでは、入力と回答全体を合わせた長さをdataset_max_lenとして設定する仕様です。一方、RLVRやRLAIF(GRPO)、RFTといった強化学習系の手法では、入力の予算となるmax_prompt_lengthと、生成の予算となるmax_response_lengthをそれぞれ独立して設定し、その合計をモデルごとの上限値以内に収める必要があります。
公式仕様では、コード生成や数学的推論のように長い出力が必要なタスクでは回答長が生成品質に影響し得ると指摘されており、期待する出力に応じた回答長を確保しつつ入力長を割り当てることが推奨されています。同時に、シーケンス長を長く設定するほど、学習例ごとのメモリや計算要件が増加する可能性がある点にも注意が必要です。
一律上限ではない仕様表の例外と固定値
発表資料には「多くのモデルで最大16Kトークン」という記載がありますが、すべてのモデルが一律に16Kトークンまで変更できるわけではありません。
公式仕様の対応表を確認すると、一部のモデルでは32Kトークンまで対応している組み合わせがある一方で、アスタリスクが付いて「4Kトークン固定で変更不可」となっているモデルや手法も存在します。また、ダッシュで示された組み合わせは、そのモデルにおいてサーバーレスカスタマイズ自体が非対応であることを意味します。そのため、モデル名だけで判断せず、採用したい手法や学習タイプとの組み合わせで設定変更が可能かを事前に確認することが不可欠です。
業務データの入力と回答を整理して比較試行する
この仕様を踏まえ、国内企業が社内データを使ってモデル調整を検討する場合、どのような進め方が考えられるでしょうか。例えば機器保守を行う企業が、問い合わせ管理システムに蓄積された過去のやり取りから回答案を作成するモデルをファインチューニングする仮定例を考えてみます。
まずは保有するデータの中から、単発の短い質問と、過去の経緯やエラーログを含む長い問い合わせを切り分け、入力に含める情報と期待する回答の長さをトークン単位で把握します。その上で、変更可能な上限に収まるモデルと手法を選定し、同じ業務評価用のデータセットを使って設定ごとの回答精度や必要項目の充足度を比較検証していく進め方が現実的です。
既存の問い合わせシステムから学習データを安全に取り出す形式や個人情報の処理、モデルが生成した回答案を担当者が確認する画面との接続など、前後のシステム連携については個別に設計を詰める必要があります。
AI導入に向けた業務整理とシステム連携の相談
モデルの学習設定を最適化するには、機械学習のパラメータを調整するだけでなく、業務側で何をモデルに渡し、どのような回答を得たいのかという業務プロセスの整理が欠かせません。
デノフのサービス案内では、業務の整理からAIを活用する業務の選定、ツール選定、導入後の定着までの支援や、予約管理・顧客管理をはじめとする業務システムの設計・開発を提供しています。社内データの取り出しや整形、既存の顧客対応システムへのAI接続など、実務への組み込みに向けた要件整理については、デノフへの相談窓口よりお問い合わせください。