社内業務やWebサービスに大規模言語モデル(LLM)を組み込んで運用していると、特定の時間帯に応答開始までの待ち時間が極端に長くなる現象に直面することがあります。ハードウェアの増強やモデルの軽量化を検討する前に見直したいのが、複数並んだ推論サーバーへのリクエストの割り当て方です。
AWSが告知したクラスタ内ルーティングと提供範囲
AWSは2026年9月24日、既存のAmazon SageMaker HyperPod基盤に向けた新しいルーティング機能として、SageMaker HyperPod Inference Gatewayの公式告知を掲載しました。これはAmazon EKSの管理アドオンとして導入され、推論を実行しているGPUの状態をリアルタイムに把握しながらリクエストを振り分けるKubernetesネイティブな仕組みです。
現在提供されているのは、HyperPodの推論アドオンに対応した各リージョンにおけるクラスタ内ルーティングです。複数のクラスタやリージョンをまたぐトラフィック制御やグローバルなレート制限などは、現時点では今後の予定とされています。まずは単一クラスタ内でのGPU負荷の最適化が対象となります。
リクエスト本文とGPUメトリクスを組み合わせた振り分け
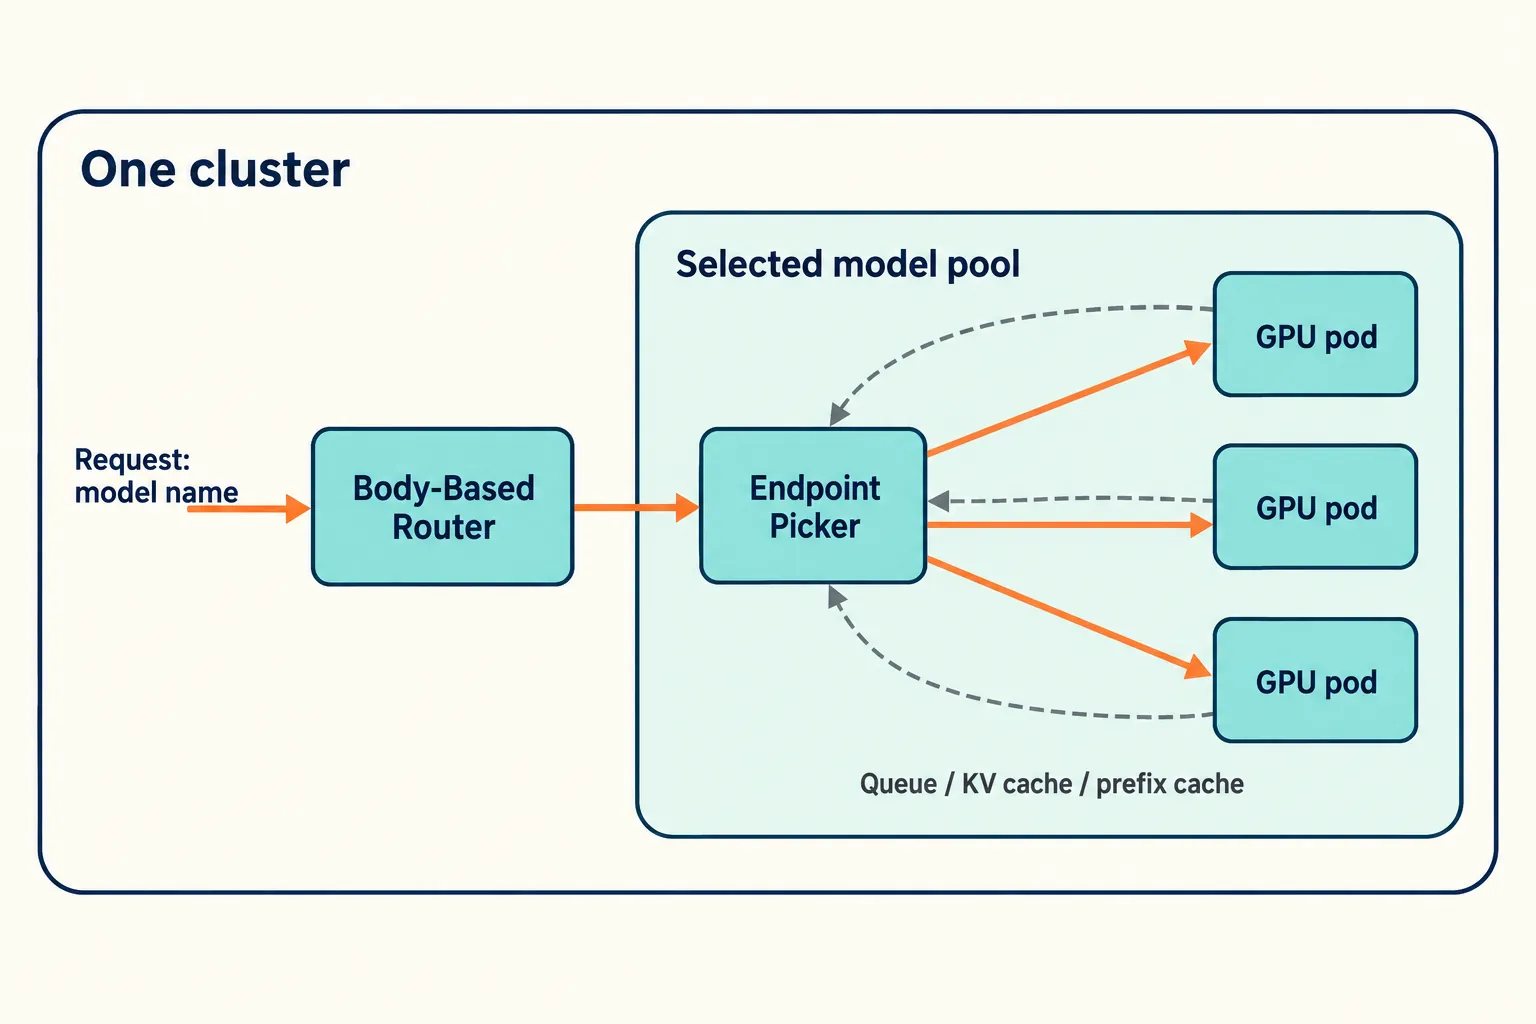
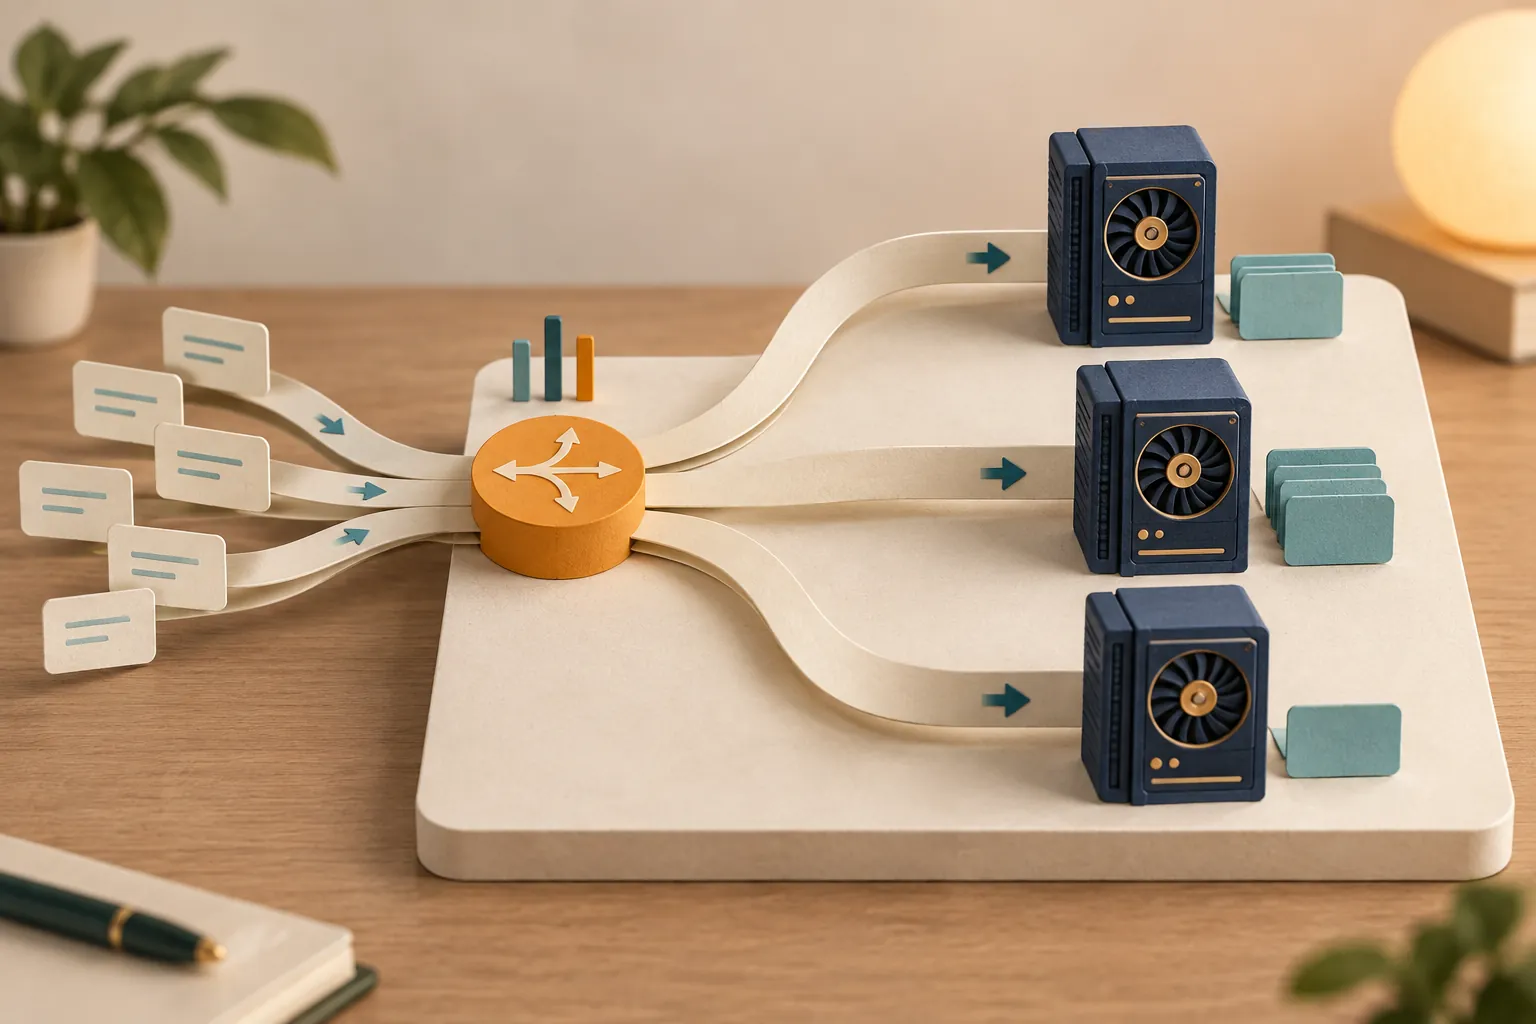
従来の一般的なロードバランサーは、各GPU内部でどのような処理が行われているかを把握できないまま、単純なラウンドロビンなどで機械的に要求を割り振っていました。その結果、一部のpodに負荷が集中して待ち行列が伸び、別のpodの容量が空いているといった偏りが生じやすくなります。
詳しい技術解説を掲載したAWS Machine Learning Blogの記事によると、Inference Gatewayは主に2つの役割分担でリクエストを処理します。
1つ目は、OpenAI互換リクエストの本文に含まれるモデル名を読み取るBody-Based Routerです。クライアント側の接続先URLを一本化したまま、要求されたモデルに応じて適切なGPUプールへ自動的に振り分けます。
2つ目は、各モデル提供podから送られるPrometheusメトリクスをもとに、最適な送信先podを動的に選択するEndpoint Pickerです。KVキャッシュの使用率、待ち行列の深さ、実行中のリクエスト数、プロンプトのprefixキャッシュのヒット率、さらにはLoRAアダプターがすでにGPUメモリ上に展開されているかといった推論状態をリアルタイムに評価し、重み付けスコアによって送り先を決定します。
AWSによるベンチマーク結果と改善が見られない条件
ルーティングの知能化によって、どの程度の性能差が生まれるのでしょうか。AWSが報告したベンチマークでは、p5.48xlarge(H100)およびg5(A10G)インスタンス上に8Bから235Bパラメータの4モデルを配置し、同じモデルレプリカに対するKubernetes標準のラウンドロビンを基準として比較が行われました。
この試験において、Llama-3.1-70Bに対して突発的なトラフィック(バースト負荷)を与えた条件では、最初のトークンが出力されるまでの時間(TTFT)がP95で94%、P99で98%減少し、スループットも12%向上したと報告されています。異なる世代のGPUが混在している環境や、共通のプロンプト接頭辞を持つリクエストが続く環境でも、同様に遅延の低減が確認されています。
ただし、この結果をすべての運用環境にそのまま当てはめることはできません。AWS自身の説明にある通り、均一なハードウェア構成に対して一定のトラフィックが定常的に流れている条件では、各レプリカの利用状況がほぼ揃うため、Gatewayの性能は従来のラウンドロビンと同程度にとどまりました。自社のワークロードにおいて、負荷の偏りや突発的なバーストが実際に遅延の原因になっているかを見極めることが導入判断の分かれ目となります。
「コード変更不要」と基盤側で必要な設定
Inference GatewayはOpenAI互換のAPI仕様に対応しており、クライアント側のアプリケーションコードやモデルサーバーのプログラムを変更せずに導入できると案内されています。vLLMやSGLangといった主要な推論サーバーをそのまま活用できる点は運用の利点です。
一方で、インフラ側の設定作業が不要になるわけではありません。公式の手順では、EKSクラスタへのアドオンの追加、既存のモデルサーバーdeploymentへの検索用podラベルの付与、そして対象モデルやルーティング動作を定義するInferenceGatewayConfigリソースの適用が必要とされています。アプリケーション側の改修が不要という点と、Kubernetesリソースの設計や監視設定の準備を分けて見積もる必要があります。
国内業務での検証シナリオとデノフの支援
自社基盤での効果を確かめる際は、全体を一気に切り替えるのではなく、業務特性に応じた比較検証から始めるのが堅実です。
たとえば、社内文書の検索・要約AIをHyperPod上で運用しており、始業直後の時間帯にアクセスが集中して応答が遅れる国内企業を想定してみます。この場合、まずは画面表示の遅れが「検索処理」「ネットワーク通信」「LLM推論の待ち行列」「実際の生成処理」のどこで生じているかを計測して切り分けます。その上で、推論段階での待ち時間がボトルネックになっていることが確認できれば、本番と同じモデル構成に対して定常時と集中時の代表的なリクエストを送信し、ラウンドロビンとGatewayでTTFTやGPU使用率の推移を比較します。
デノフでは、Webサイトや業務システムの設計・開発・運用保守の経験を活かし、AIを業務へ組み込む際の全体設計や既存システムとの接続を支援しています。詳しくはデノフのサービス案内に記載している通り、ツールの選定や業務フローの整理から、要件が固まっていない初期段階のご相談まで承っています。
推論基盤の改善にとどまらず、業務システム側での非同期処理やキャッシュ設計を含めて応答遅延を解消したいとお考えの際は、デノフへの相談窓口よりお気軽にお問い合わせください。現状の処理フローとボトルネックの整理から具体的な進め方を検討いたします。