会話的な回答と推論に対応したStandard tierの追加
社内の業務マニュアルや製品FAQを参照して利用者の質問に答える生成AIでは、回答が参照元の資料に沿っているか、そして質問の意図から逸脱していないかを検証する仕組みが欠かせません。AWSが2026年10月20日に公表した発表によると、Amazon Bedrock Guardrailsの根拠確認機能であるcontextual grounding checksに、新たに「Standard tier」が追加されました。
従来のClassic tierは、要約や言い換え、単発の質疑応答といった厳密な一致が求められる用途を想定しており、会話の文脈を含む応答には対応していませんでした。一方、新たに追加されたStandard tierでは、参照資料をもとに筋道立てて推論を行う回答や、会話的な表現を含む応答に対しても根拠確認を適用できるようになっています。同じ意味を保ったまま表現を変えた回答に対しても、より一貫したスコア判定が行われるよう改善されています。
根拠づけと関連性を分けて評価する仕組み
contextual grounding checksの動作を理解する上では、モデルの回答を2つの異なる軸でスコア化する点が重要です。Amazon Bedrockの公式ドキュメントに示されている通り、この機能は外部の知識を独自に検索して真偽を調べるものではなく、システム側から渡された「参照資料」と「ユーザーの質問」を基準に評価を行います。
1つ目の評価軸であるgroundingは、回答内容が参照資料の事実に正確に基づいているかを判定する指標です。参照資料に基づく推論であればStandard tierでは許容されます。一方で、資料で裏付けられない新しい情報や条件が回答に含まれる場合は、根拠が薄いとみなされてgroundingスコアが下がります。2つ目のrelevanceは、回答が利用者の質問に答えているかを判定する指標です。参照資料の内容をどれほど正確に引用していても、質問と関係のない話題を話していれば関連性スコアは低くなります。この2つの判定が組み合わさることで、「資料に沿っているが質問の答えになっていない回答」や「質問に答えているように見えるが資料にない内容を付け足した回答」を切り分けて検出できます。
切り替え時の注意点とcross-Region inferenceの要件
すでにBedrock Guardrailsを利用している環境であっても、既存のguardrailが自動的にStandard tierへ移行することはありません。利用者が設定を変更するまではClassic tierがそのまま維持されます。運用中のシステムでtierの変更を検討する際は、いくつかの技術的・運用的な前提条件の確認が必要です。
まず、判定処理の方式が異なるため、同じ回答であってもClassic tierとStandard tierでは算出されるスコアが変わる可能性があります。公式ドキュメントでも、既存guardrailのtierを変更する前には、自社のデータを用いてgroundingとrelevanceの閾値をテストするよう案内されています。管理画面やAPIではスコアの閾値を0から0.99の間で調整できますが、従来の数値をそのまま引き継ぐのではなく、自社の業務で許容される表現が不当に遮断されていないかを検証する手順が不可欠です。
また、Standard tierを利用するには、guardrail profileを指定したクロスリージョン推論であるcross-Region inferenceを有効化する必要があります。処理要求がプロファイルで定義されたリージョンへルーティングされる前提となるため、社内で扱う文書の機密性やデータの取り扱い規定に照らし合わせて、処理先リージョンが自社の運用基準に適合しているかを事前に確認しておくことが大切です。
ストリーミング表示の制約と回答確認の接続設計
業務システムへ根拠確認を組み込むにあたり、見落としやすいのが回答の表示タイミングに関する制約です。公式ドキュメントによると、処理されたチャンクの中に1つでも質問に関連するものがあれば、回答全体が関連ありとみなされます。一方、ストリーミングAPIでは、質問と無関係な回答が利用者へ返され、全体の配信が完了した後に初めて関連性なしと判定されるケースがあると説明されています。
誤った案内や無関係な回答を利用者に先に見せることが許されない業務では、文字を逐次表示するストリーミングではなく、回答全体が生成された後に確認処理を通し、判定が完了してから利用者の画面へ表示する設計が現実的な選択肢です。
さらに、モデル呼び出しを伴わない単体判定APIであるApplyGuardrailを利用する場合、入力として参照資料と質問を渡すだけでなく、検証対象となる「生成済み回答」を明示的なコンテンツブロックとして別途渡す必要があります。既存のチャットエンジンや社内システムとつなぎ合わせる際には、回答生成処理の直後にこのAPIを呼び出し、スコアに応じた分岐処理を挟む構成を設計します。
国内の業務を想定した適用例と評価の進め方
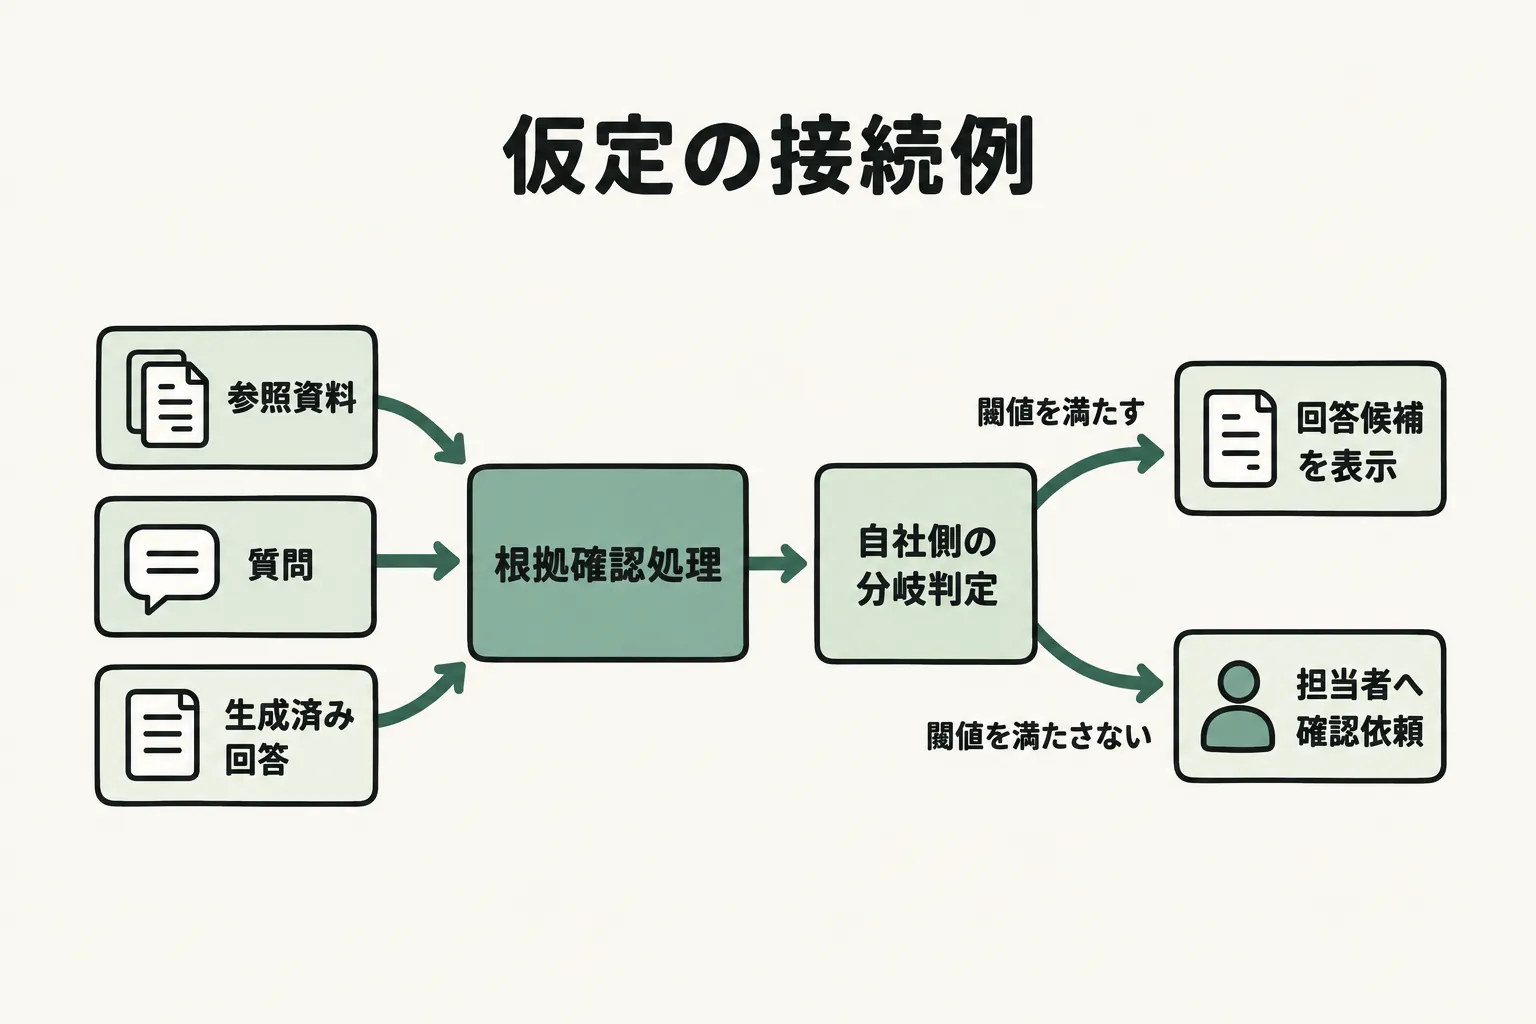
ここまでの仕様を踏まえ、国内企業での具体的な業務フローへどう落とし込めるかを整理します。たとえば、設備の保守点検や修理受付を行う企業が、承認済みの社内FAQを参照して問い合わせ対応の下書きを作成する場面が一例です。
この仮定の構成では、オペレーターが入力した質問と参照用FAQをもとにAIが回答案を生成し、その回答案・FAQ・質問の3点をApplyGuardrailへ送って根拠確認を実行します。確認結果のスコアが設定閾値をクリアしていれば、オペレーターの画面へ回答候補を表示する設計です。閾値を下回った場合は、根拠づけが不足しているのか質問との関連性が低いのかに応じた注記とともに、該当のFAQ箇所を添えて担当者へ引き継ぎます。
この仕組みを検証する段階では、あらかじめ自社の問い合わせパターンに応じた評価用データの準備が有効です。評価用データには、FAQの表現を自然に言い換えた正解例だけでなく、質問と無関係な案内が混ざった例や、FAQには記載されていない無償対応などの条件を勝手に付け足した回答例を含めます。それらを実際に判定処理に通すことで、どこまでの言い換えなら正しく通過し、どのような逸脱を遮断できるのか、業務に適した閾値の基準を見極めることができます。
あわせて、根拠資料として渡すFAQの版管理や、判定を待つ間の画面インターフェース、確認処理でエラーが生じた場合の業務手順など、APIの外側にある業務要件の整理も円滑な運用の鍵です。
問い合わせ対応の整理とシステム連携のご相談
生成AIを活用した問い合わせ対応では、高機能なガードレールを導入する設定作業だけでなく、どの業務にどの資料を参照させるかという前提の整理や、既存の業務画面へどのような手順で回答・確認結果を届けるかという全体設計が重要になります。
デノフのサービス案内でもご紹介している通り、弊社では業務の整理からAIを活用する業務の選定、ツール選定、そして現場に合わせたシステム開発や運用の定着までを一貫して支援しています。既存の顧客管理システムや問い合わせ窓口と回答確認の仕組みをどう接続すべきか、どのような評価例を用意して段階的に導入を進めるかなど、具体的な構成に迷われた際は、デノフへの相談窓口よりお気軽にお問い合わせください。