複数の仕入先から商品データを取り込むECサイトや卸売の業務では、同一商品であっても仕入先ごとに商品名、型番、属性の記載方法が異なり、データ連携の負担となるケースが考えられます。バーコード(JANコードなど)を手がかりに照合する場合でも、コードの欠落や独自品番の存在だけでなく、コードの値自体の信頼性が常に担保されているとは限りません。そのため、キー情報だけで一括照合できない状況が想定されます。
2026年10月20日、ECプラットフォーム大手のShopifyは、数百万の店舗にまたがる膨大な商品群を単一の識別子(UPI: Universal Product Identifier)へまとめる技術設計をShopify Engineeringの技術ブログ(Part II)で公表しました。同社は2026年6月に店舗内クラスタリングを解説した技術ブログ(Part I)で、単一店舗内のバリエーション分類を発表していましたが、今回の取り組みは異なる店舗間をまたいで同一商品を照合する、より難易度の高い課題に踏み込んだものです。
類似度だけでつなぐと「誤統合」が連鎖する
商品名や画像の特徴量をベクトル化し、類似度が高いものを自動でまとめればよいと考えがちですが、実運用ではそれだけでは破綻します。たとえば、スマートフォンケースで「iPhone 15用」と「iPhone 15 Pro用」は、ブランド名やシリーズ名、商品説明の大部分が一致するため全体の類似度は極めて高くなります。しかし、対象機種というわずかな相違点によって、これらは明確に別商品として扱わなければなりません。
さらに厄介なのが、似ている商品同士を数珠つなぎに連結してしまうリスクです。商品Aと商品Bが類似し、商品Bと商品Cが類似していたとしても、商品Aと商品Cが同じ商品であるとは限りません。類似ペアのつながりを無条件にたどってグループ化すると、わずかな誤判定を媒介にして全く無関係な商品群全体がひとつのグループへ誤統合されてしまいます。Shopifyはこの問題を重く見て、誤統合を抑えて統合対象の正しさを高める適合率を優先してモデルの受け入れ閾値を調整し、その制約内で再現率を最大化する方針をとっていると説明しています。間違えて統合してしまう損害は、照合が漏れて単独のまま残る不都合よりもはるかに大きいからです。
候補検索、段階的スコアリング、グループ統合の役割分担
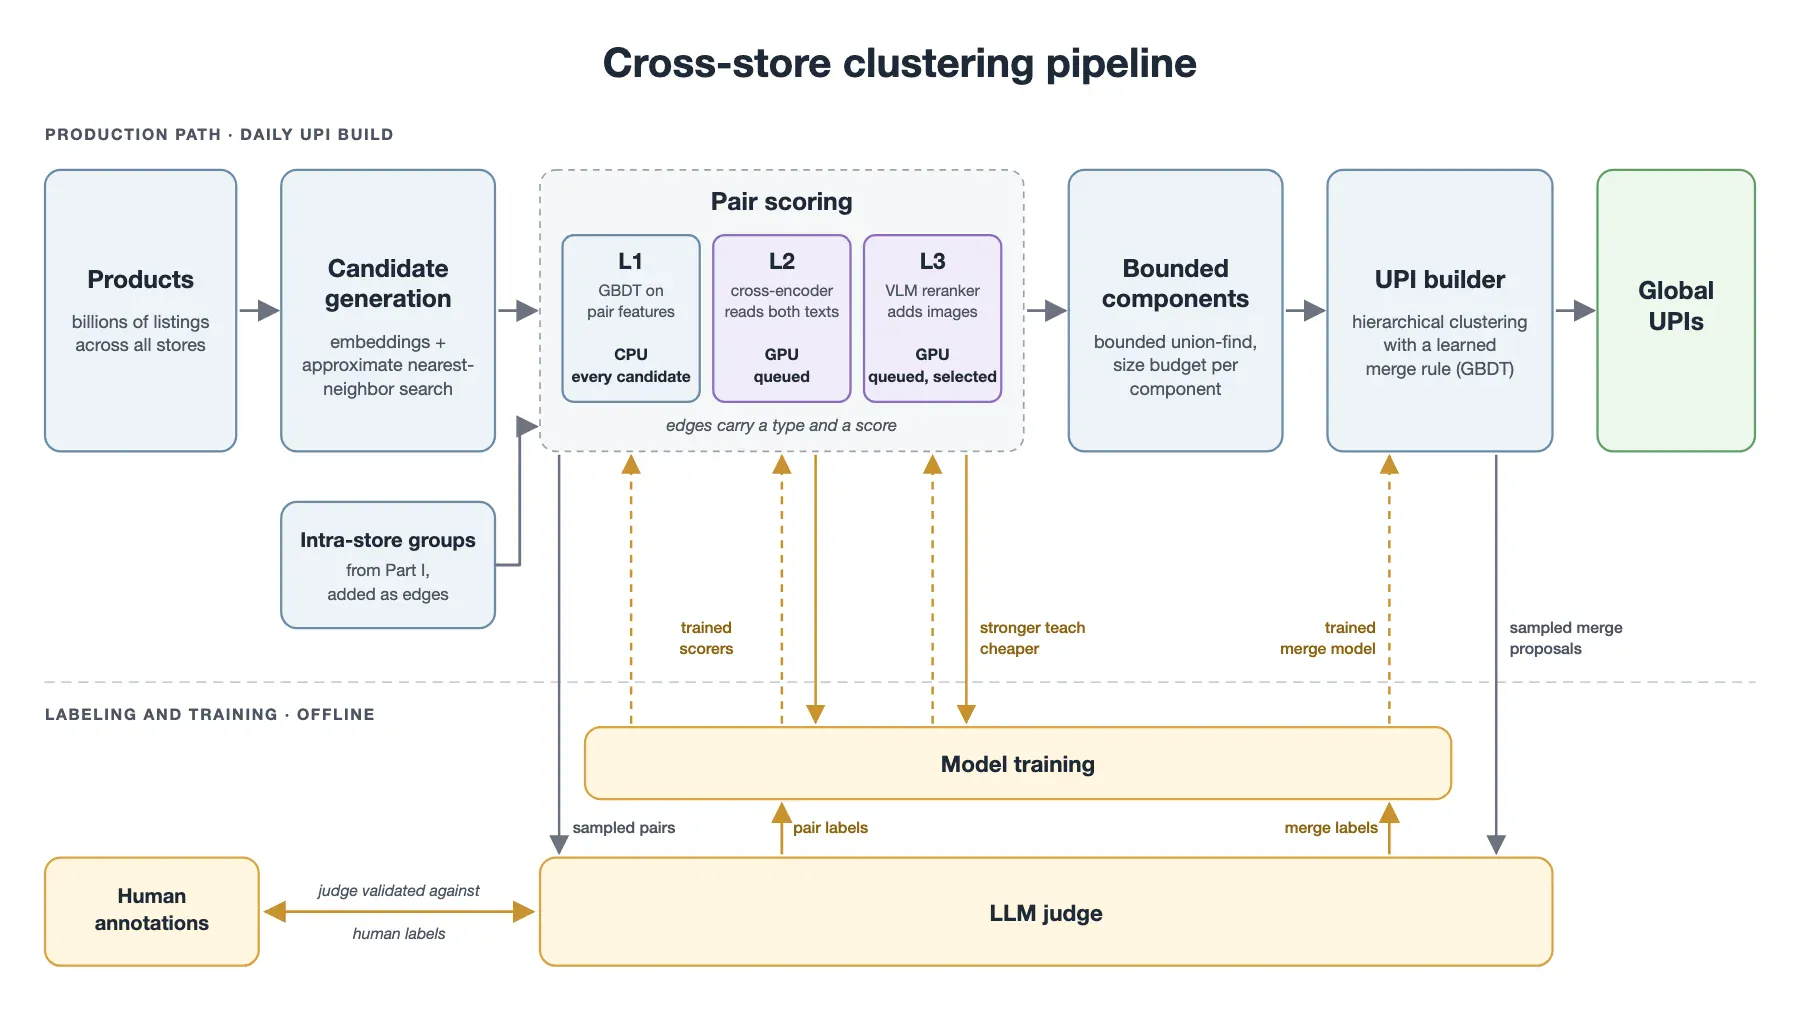
膨大な商品データから高精度な照合を行うため、Shopifyでは処理を「候補の絞り込み」「ペアのスコアリング」「商品群の統合判断」という3段階に分離する設計をとっています。
第一段階の候補検索では、商品の埋め込みベクトルと近似最近傍検索を用いて、類似する商品の候補リストを作ります。計算量を実用的な範囲に抑えるための近似処理や候補数の上限設定により、真の一致ペアが候補から漏れる制約は残りますが、後段の重い判定モデルへ渡す計算量を現実的な規模に絞り込む役割を担います。
第二段階のペア判定では、コストと精度の異なる3つのモデル(L1・L2・L3)を段階的に使い分けています。
- L1(低コストな特徴量判定)埋め込み間の距離、商品名やブランドの類似度、価格関係などの特徴量を用い、勾配ブースティング決定木(GBDT)で候補ペアを高速にスコアリングします。
- L2(テキストの同時読み取り)両商品の商品名、ブランド名、カテゴリ、URLなどをクロスエンコーダでまとめて読み取り、前述した型番や対応機種のわずかな差異を詳細に比較します。ただしL2の入力には商品説明文が含まれていないため、違いが説明文の中にしか書かれていない場合は見落とすという制約があります。
- L3(画像と詳細メタデータによる判定)テキストだけでは判別が難しい選定済みのペアに対し、商品画像や豊富なメタデータを加えて詳細な照合スコアを算出します。
第三段階のUPIビルダーでは、ペアのスコアだけでなく、商品群全体の結合状況を評価します。両グループをつなぐ接続の多さ、商品全体にわたる結びつきの広がり、グループ内部の結束度、そして低スコアの否定証拠が存在しないかを学習済みモデルで総合判定し、商品群同士を合併してよいかを決定します。
変更データへの対応と日次更新の工夫
商品カタログは日々更新されます。新しい商品が追加されたり、既存商品のタイトルや画像が修正されたりするたびに、すべての組み合わせを最初から再推論していては計算コストが追いつきません。
Shopifyの運用では、判定モデルや関連する商品特徴に変更がない場合、過去に計算したスコアをキャッシュして再利用します。日次のUPI構築処理では、その時点で得られているL1結果と、バックグラウンドのキュー処理ですでに計算済みのL2・L3スコアを組み合わせてグループを更新し、推論処理がすべて完了するのを待たずに日次処理を回す設計をとっています。高負荷なGPU推論を一定ペースで継続させつつ、日々のカタログ更新を滞らせないための現実的な工夫です。
国内EC・商品台帳への応用と小さな試行範囲
この考え方は、日本のEC事業者や卸売企業が仕入先データと自社商品マスタを照合・連携する業務にも応用が考えられます。ただし、公表されているShopifyの仕組みはあくまで同社内部の基盤設計であり、管理画面の設定や標準機能だけでそのまま利用できるかは確認されていません。自社の基幹システムや商品管理ツールと連携させる際も、既存機能で対応できる範囲や接続仕様を調査したうえで、個別の要件整理や実装が必要かを検討することになります。
実在の導入案件ではない仮定例として、複数の仕入先から異なる形式で商品データを受け取る国内EC事業者が、自社の商品台帳と自動照合する仕組みを試作する場合を考えてみます。
まず、商品群としてまとめる単位と、受発注や在庫管理で区別する販売単位の違いを整理することが大切です。Shopifyが店舗内クラスタリングで示したように、買い手の購入目的を基準にする考え方では、商材によって色やサイズなどの属性がバリエーションにとどまることもあれば、用途を変える属性として別商品に分かれることもあります。しかし、そうして束ねられる商品群の識別子は在庫管理の個別単位と粒度が異なる場合があるため、仮定例では、受発注に必要な仕入先の元コードやJANコードを直接上書きするのではなく、商品群としての対応関係や販売単位との対応候補を別テーブルに保持し、どの粒度で照合しているかを明確にする構成をとります。
次に、いきなり全自動でマスタ統合を行うのではなく、AIによる照合候補と判定根拠(類似スコアや一致した型番など)を社内の担当者へ提示し、確認画面上でチェックする小さな試行から始めます。特に紛らわしい型番違い、入数の違い、セット品などが含まれる商材をあらかじめ抽出し、AIがどの項目を読み落としやすいかを検証します。識別に必要な情報が商品名にあるのか、仕様欄や説明文、パッケージ画像にしかないのかを確かめることで、判定モデルに渡すべき入力項目が明確になります。
さらに、仕入先側で商品名や画像が更新された際には、更新日時と変更項目を検知し、過去の判定結果をそのまま維持できるか、再確認へ回すべきかを振り分けるルールを定めておくアプローチが考えられます。日々の確認工数を抑えながら、誤ったマスタ統合に伴う誤出荷やトラブルをどの程度抑止できるかを検証していく狙いです。
商品データの照合・連携を具体化するために
商品照合の自動化を検討する際、最初から完璧な自動判定を目指す必要はありません。現在の照合作業でどこに目視確認の負荷がかかっているのか、既存のECシステムや商品台帳からどのような形式でデータを入出力できるのかを整理することが現実的な第一歩となります。
株式会社デノフでは、デノフのサービス案内に記載のとおり、ECサイトや社内業務システムの設計・開発から、AIを活用した業務整理、ツールの選定、導入後の運用保守までを一貫して支援しています。本事例のような海外の大規模モデルをそのまま再現するのではなく、各企業の商材や運用体制に合わせて、照合候補と根拠を確認できる社内ツールの試作や、既存商品台帳とのAPI・ファイル連携の設計を行います。
仕入先ごとの商品データ整理に課題を感じている方や、既存の業務フローに合わせたAI活用の現実的な進め方を検討したい方は、デノフへの相談窓口よりお気軽にご相談ください。現在の業務手順やデータの状態をもとに、どこまでをルールや既存機能で処理し、どの部分に判定支援を組み込むべきか、具体的な進め方を整理いたします。