レコード全体の書き換えを避ける個別特徴量更新
2026年9月8日、AWSは機械学習向けデータ基盤であるAmazon SageMaker Feature Storeにおいて、レコード内の個別特徴量を更新できる新機能「feature-level writes」の提供を開始したと発表しました。詳細はAWSの新機能発表資料で公開されています。
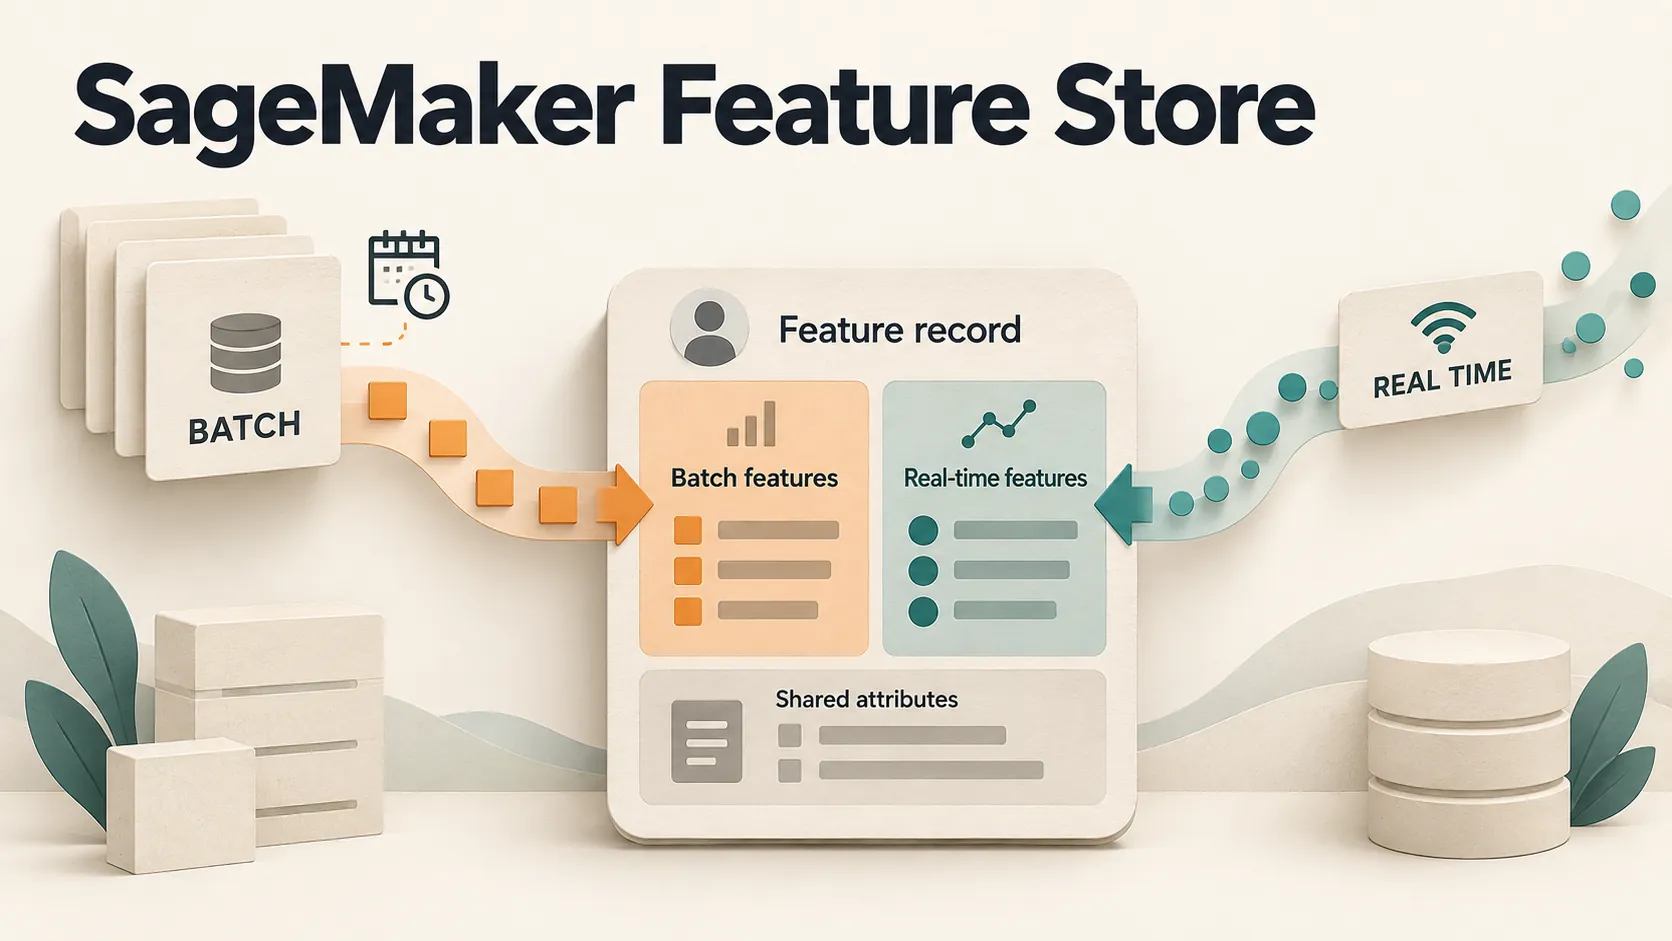
機械学習モデルの推論や学習に用いる特徴量を管理する際、AWSの説明によると、データサイエンティストは今回の更新呼び出しによって、現在パイプラインで実行されている「リード・モディファイ・ライト」のパターンを置き換えることができます。今回の機能追加により、データサイエンティストはレコード全体を書き換えることなく、1回のリクエストで1つ以上の特徴量値のみを指定して更新できるようになり、リクエストに含まれない同一レコード内の他の特徴量は変更されずに保持されます。AWSはこの仕組みによって書き込みの遅延やコストの抑制につながるとしています。
ストリーミング処理と夜間バッチ処理の独立更新
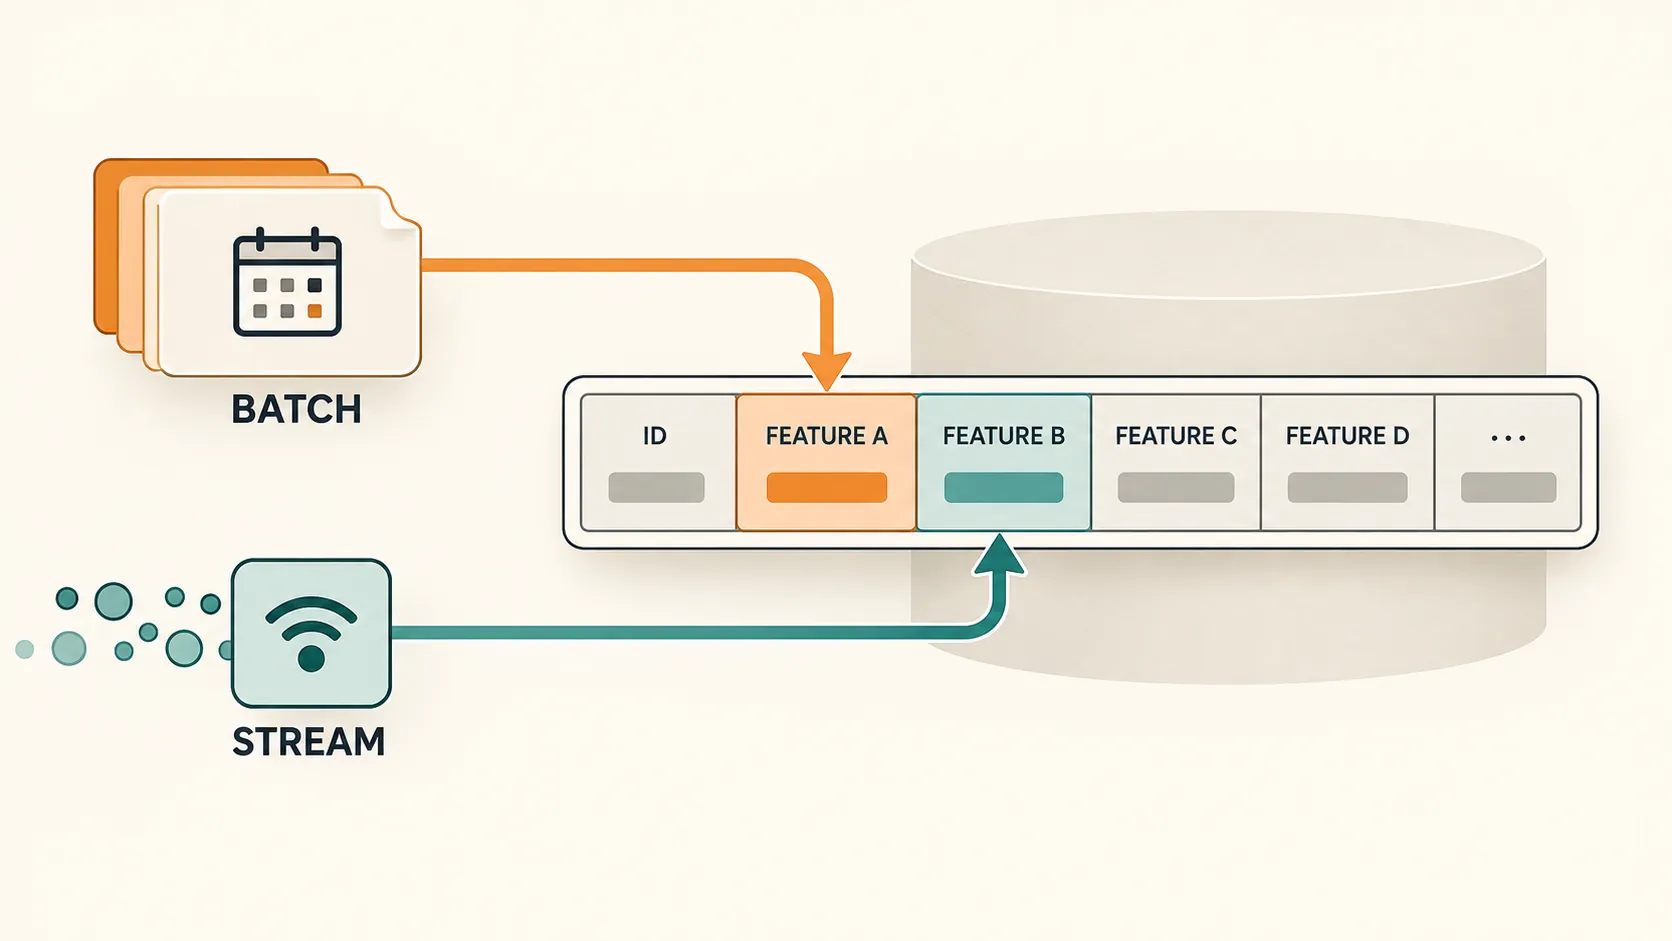
今回の発表で実務上注目されるのが、複数のデータパイプラインが同一のデータ群(フィーチャーグループ)に書き込む際の役割分担です。AWSの発表資料では、ストリーミングジョブと夜間バッチジョブが同じレコードを独立して更新できる例が挙げられています。各処理系が自ら算出した特徴量だけを更新対象にできるため、データ取り込みパイプライン側で複雑なマージロジックを独自に構築する必要がなくなると説明されています。この機能は、SageMaker Feature Storeが利用可能なすべてのAWSリージョンで提供されています。
そもそもAmazon SageMaker Feature Storeの製品解説にあるように、このサービスはアプリケーションログ、サービスログ、クリックストリーム、センサーデータ、表形式データなど多様なデータ源から特徴量を取り込み、モデル学習用のオフライン保存とリアルタイム推論用のオンライン保存の同期を維持する役割を担っています。一方で、即時性が求められる行動ログの処理と夜間にまとめて集計する基幹データの処理が同一レコードを更新するような個別システムを設計する際には、更新タイミングの不一致や競合、データの整合性をどのように扱うかが検討事項となります。
自社の既存データパイプラインに応用する視点
この仕組みの考え方は、クラウドサービスの設定にとどまらず、既存の業務システムからAIモデルへデータを供給するパイプライン全体の設計にも通じるものがあります。
実在の案件ではない仮定の例として、ECや卸業務において「直近のWeb行動ログから算出する購買意欲スコア」と「夜間の基幹システム集計から算出する過去30日間の購買頻度」の双方を特徴量として組み合わせ、需要予測や推薦を行うケースを考えてみます。行動ログのストリーミング処理と夜間バッチ処理が同一顧客のレコードを更新する場合、更新単位がレコード全体になっていると、夜間集計の書き込みが日中の行動ログによる更新結果を巻き戻してしまったり、逆にログ更新がバッチ処理の反映と衝突したりする恐れが生じます。
各処理がどの特徴量の更新に責任を持つかを明確に分離し、担当外の値を書き換えないインターフェースを設けることで、処理間の不要な依存関係を減らせます。ただし、実際の運用にあたっては、更新が重なった場合の順序制御や整合性の担保要件、データソースごとの接続仕様など、個別のデータ構造に応じた事前検証が欠かせません。
連携範囲の整理と導入検討の進め方
AIモデルの選定や精度検証に目が向きがちですが、安定した運用の成否は既存の業務データをいかに無理なく連携・更新し続けられるかに左右されます。まずはAIに活用したい業務データを洗い出し、それぞれの更新元システム、更新頻度、リアルタイム推論と学習バッチのどちらで利用するのかを整理することが、設計の第一歩となります。
Feature Storeの個別特徴量更新のような確認済みの標準機能で対応できる範囲と、既存データベースやAPIとの接続方式、更新順序、権限管理、データ品質など個別検証が必要な範囲を切り分けて整理することが検討の軸となります。実際の連携効果や再処理の要否は個別のシステム環境やデータ構造に左右されるため、事前の見極めが欠かせません。デノフのサービス案内では、業務システムの設計・開発からAI活用支援まで、実務に合わせた技術支援を行っています。社内に蓄積された既存データのAI連携や更新フローの整理、システム間の連携範囲の検討について具体化を進めたい場合は、デノフへの相談窓口よりご相談いただけます。