モバイル固有の入力経路を分類し、監査の観点を補う
GitHub Security Labが公表したGitHub Security LabのAndroid向け脆弱性調査に関する公式記事によると、執筆時点までに合計24件の脆弱性を発見・報告したと述べられています。これは著者らによる自己報告であり、すべての脆弱性が公開済みであったり重大な問題であったりすることを示すものではありませんが、AIエージェントのプロンプトとワークフローを対象環境に合わせて調整した実践例として示唆に富んでいます。
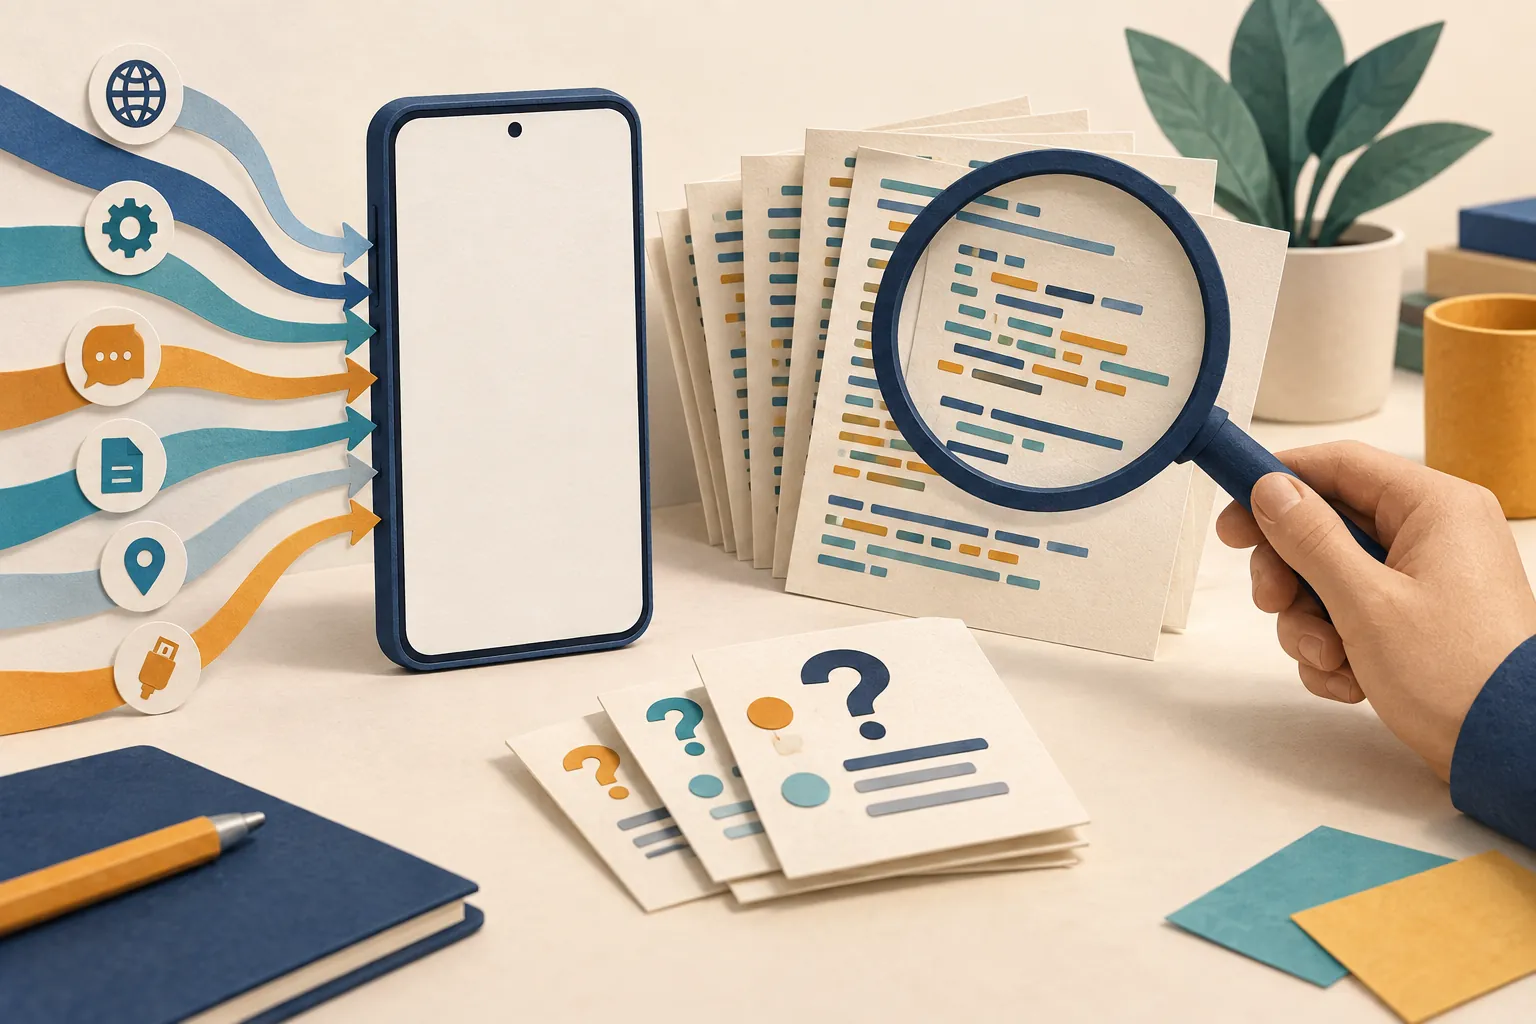
この取り組みで重視されたのは、調査対象のリポジトリ内に存在する多様なコンポーネントの中から、攻撃者が操作できるデータの入口を適切に特定することでした。著者らは新たなワークフローを追加し、入力経路をモバイル向けとそれ以外に分離しました。これにより、モバイルアプリだけでなくWebサーバーやデスクトップ向け機能が混在するリポジトリであっても、AIが対象に応じた攻撃面を把握できるよう促しています。
さらに、代表的な脆弱性の種類を指定したうえで、それぞれの入口やコンポーネントの文脈に沿って検討させる指示を加えました。モバイルアプリの脆弱性は比較的知られておらずモデルの非決定性もあるため、たとえばインテントを介した入口が見つかった場合には代理人攻撃や安全でないブロードキャストといった特有の論点を指定し、必須の確認観点を見落とさずに潜在的な問題へ目を向けさせる工夫をしています。
想定した呼び出し元と外部入力のずれが招く問題
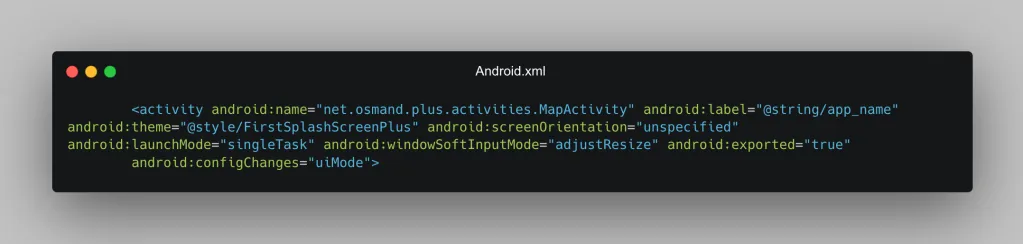
原典では、実際に報告された具体例としてオープンソースのナビゲーションアプリ「OsmAnd」の事例が挙げられています。このアプリでは、設定ファイルの取り込みなどを処理する画面コンポーネントが外部に公開されていました。このコンポーネントは内部のプロセス間通信サービスから設定情報を受け取ることを想定していましたが、Androidの仕組み上、外部のアプリからも任意の追加データを付与したインテントを送信できる状態になっていました。
その結果、利用者に通知することなく設定を上書きし、地図タイルの取得先を攻撃者のサーバーへ向けさせて位置情報を外部に漏洩させることが可能な状態が生じていました。コードの一部だけを見ていると内部処理として完結しているように見えても、外部から誰がどのような経路で値を渡せるのかという前提がずれていると、重大な不具合につながります。AIにコードを調査させる際にも、こうした入力経路と許容される操作の境界をあらかじめ整理して伝えることが重要になります。
土台となる3段階の工程分割と、AIが抱える重大度評価の限界
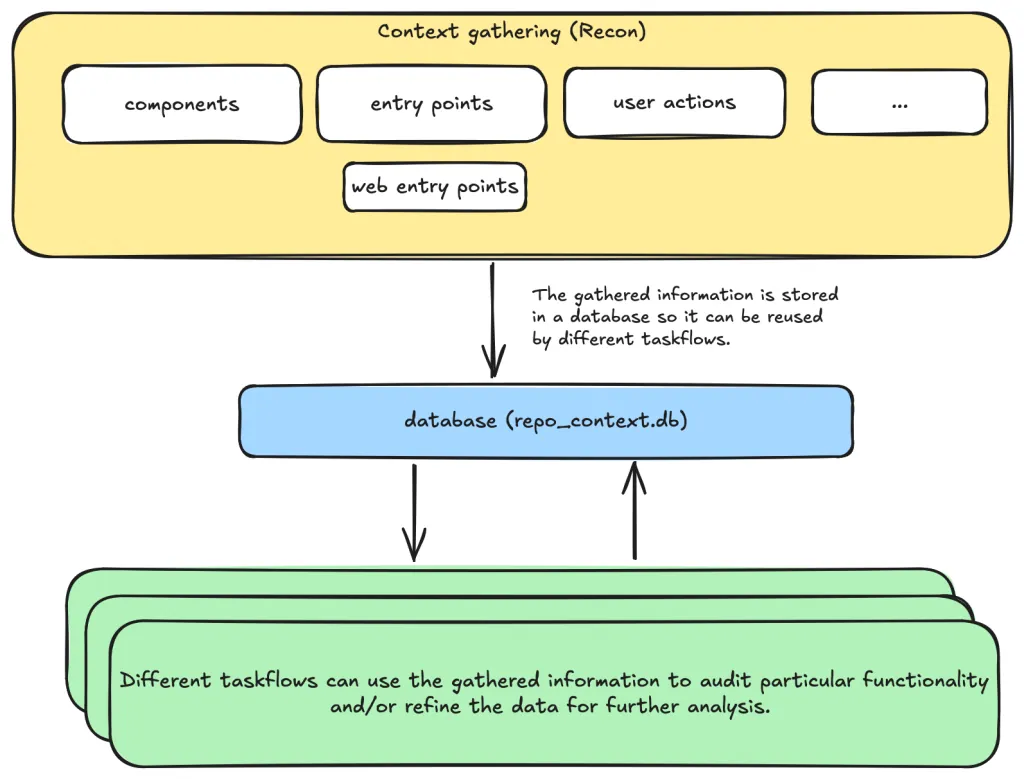
Android向けに調整されたこれらの手法は、以前に公開された汎用的なセキュリティ監査の仕組みが土台になっています。Taskflow AgentによるWeb向け脆弱性スキャンを解説した記事では、調査を一度のプロンプトで終わらせるのではなく、複数の工程に分割して進める設計が説明されています。
まず対象の機能や用途、入力経路を収集して脅威モデルを整理し、次に各コンポーネントで発生しやすい脆弱性の候補を提案させ、最後にその候補を別のタスクへ引き渡して厳格な基準でコード監査を行うという流れです。コード監査の工程では、指摘の根拠となるファイルパスや行番号を記録させ、現実的な攻撃シナリオが成立するかを検証させています。ただし、この補助原典で扱われているのはWebアプリケーション向けの成果であり、Android調査の数値と混同しないよう注意が必要です。
工程を細かく分けても、AIによる評価には依然として限界が残ります。Androidの事例において原典は、現実には成立しにくい特殊な条件を必要とする問題や、影響が極めて小さい軽微な問題をAIが報告する場合があると指摘しています。内部ストレージの優先処理など、コード全体の複雑な挙動によって実際には影響が生じないケースもあり、指摘された重大度が実際と食い違うことも少なくありません。そのため原典では、AIの検出結果を鵜呑みにせず、モバイルアプリの知見を持つ研究者が各指摘を直接確認することを強く推奨しています。
国内の保守業務へ小さく取り入れるための前提整理
海外の先端事例を自社の業務システムや社内アプリの保守へ応用する場合、まずはAIに任せる範囲と人間が介在する確認手順を明確に切り分ける必要があります。原典のツールを実行するにはGitHub Copilotのライセンスが必要であり、プロンプトの実行にはpremium model requestsが消費されます。また、多数のツール呼び出しによって大量のトークンが消費される旨も注意喚起されています。こうした消費量や人間による確認負担を踏まえると、最初からすべてのコードを対象にするのではなく、調査対象を絞って進める運用設計が現実的な提案となります。
たとえば、配送管理を担う企業が自社の配送員向けAndroidアプリと管理用Webシステムを保守している場面を仮定してみます。いきなり全体を自動監査しようとするのではなく、まずはアプリ間連携や外部リンクで値を受け取る機能など、外部からの入力経路を限定して対象を選びます。そのうえで、誰がどのような権限でその機能を呼び出す想定なのかを整理し、AIへ渡す前提条件とします。
AIが抽出した指摘については、根拠として示されたファイルや行番号をもとに、担当者が検証環境で再現条件を確認します。実際に影響が生じる不具合と判明したものだけを既存の課題管理ツールへ起票して修正対応に回すことで、誤検知に振り回されずに保守業務へ新しい調査手法を組み込めます。設定だけで適用できる範囲や実際の検出性能は対象の構成によって異なるため、まずは小さな機能から検証を進めることが現実的です。
調査結果の確認工程とシステム連携のご相談
業務で利用するアプリやWebシステムにおいて、AIを活用したコード調査を導入するには、自社の権限仕様の整理や、AIの出力を開発現場の保守手順へどう受け渡すかという運用設計が欠かせません。
デノフのWeb・システム開発およびAI活用支援サービス案内では、業務の整理からAIを活用する業務の選定、ツール選定、導入後の定着までを一貫して支援しています。また、Webサイトや社内業務システムの設計・開発・運用保守を日常的に手がけており、仕様の確認から公開後の保守体制づくりまで継続して対応しています。
AIによるコード確認を既存の保守手順へどう組み込むべきか、どの業務から小さく試行すべきかなど、ご依頼内容が具体的に固まっていない段階から課題の整理をお手伝いします。現在の保守体制やシステムの入力経路に合わせた進め方をご検討の際は、デノフへのお問い合わせ窓口よりお気軽にご相談ください。