プログラムのコードや設定ファイルに含まれるAPIキーやパスワードといった秘密情報の検知は、多くの開発現場で行われています。しかし、単純な正規表現などのパターンマッチングだけで検出を厳しくすると、ドキュメントのサンプル値やテスト用のダミー文字列まで警告され、開発者の作業を頻繁に止める原因になります。逆に警告を緩めれば、本物の認証情報が混入する危険が高まります。
このトレードオフに対して、GitHubは2026年10月13日に技術解説を公開し、従来の正規表現による候補抽出と、微調整した小型のエンコーダーモデル「ModernBERT」による文脈分類を組み合わせた新しいパイプラインの仕組みを明らかにしました。
正規表現と小型分類器の役割分担
GitHubが説明する検出パイプラインは、既存の確定的なルール処理をAIに置き換えるのではなく、正規表現と機械学習モデルそれぞれの得意領域を組み合わせています。
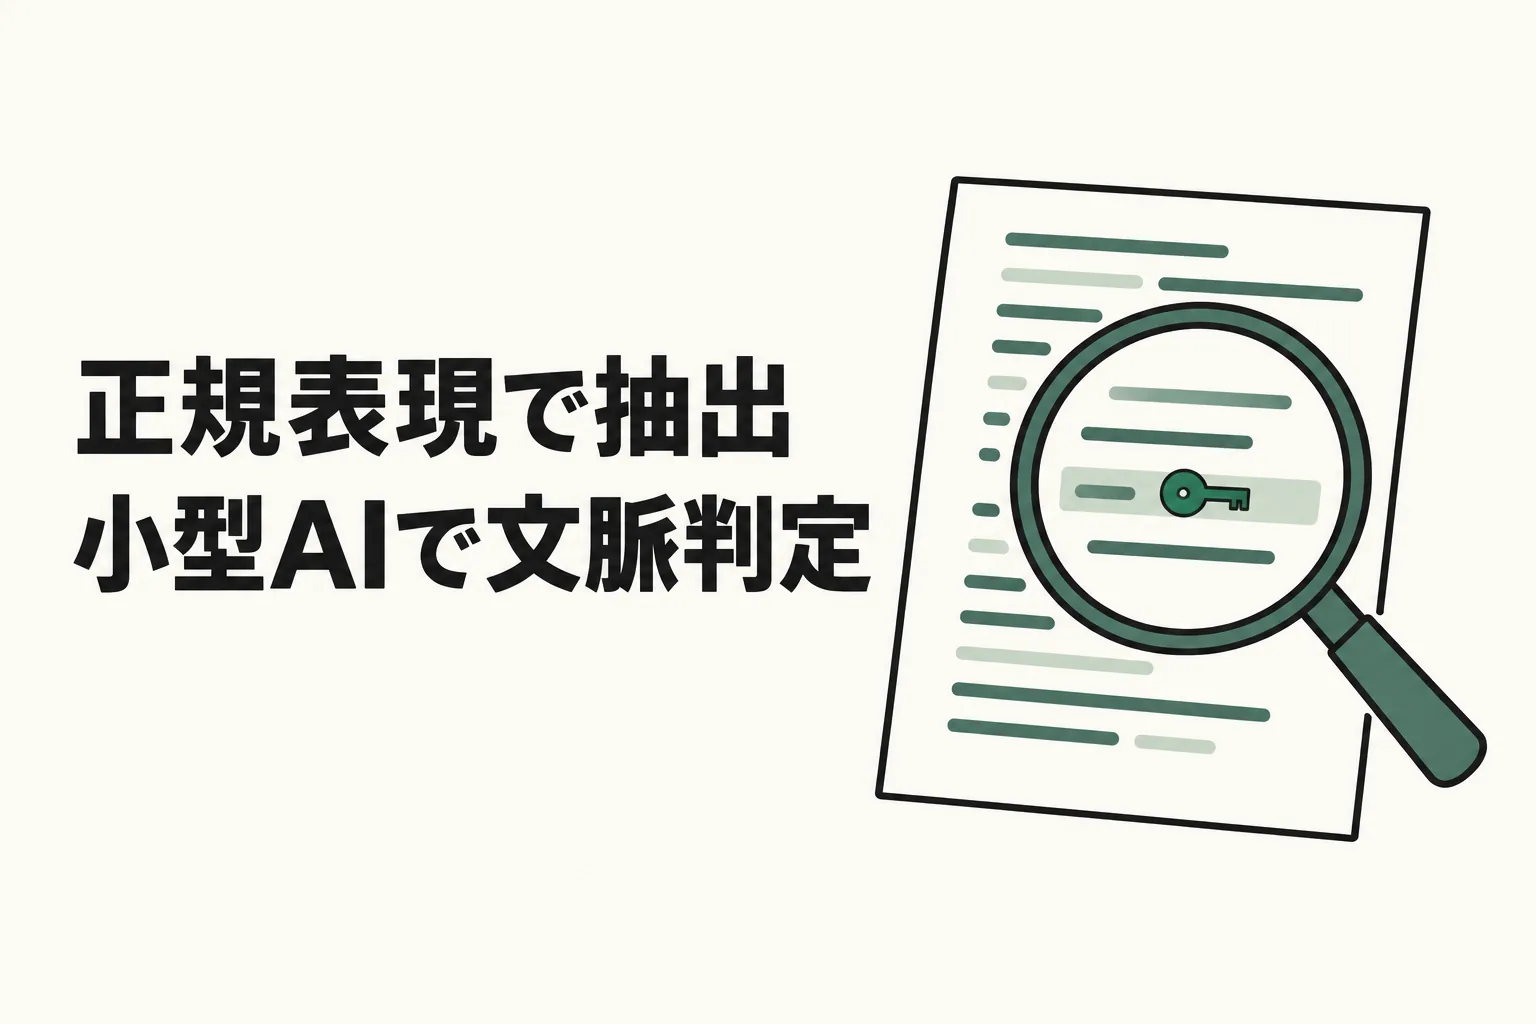
まず第1段階として、正規表現を用いてリポジトリの内容から秘密情報らしい文字列を網羅的に抽出します。この段階では見逃しを防ぐために高い再現率(網羅性)を重視し、幅広い候補を高速に拾い上げる設計です。
次に第2段階として、抽出された候補文字列を、微調整したModernBERT分類器へ渡します。この分類器は候補の値だけでなく、ファイルパス、変数名、周囲のコードやテキストといった文脈情報を同時に読み込み、本物の秘密情報である確率を推定する仕組みです。確信度の高いものだけをアラートとして通知し、プレースホルダーやテスト用データのような似て非なる文字列は除外します。
一般的な大規模言語モデル(LLM)のように自然言語の回答文を生成させるのではなく、コード周辺のテキスト分類に特化した小型モデルを採用したことで、低遅延かつ高スループットな推論を実現したと説明されています。
誤検知しやすい例の学習とデータの分離
この分類器の学習では、単に本物の秘密情報を集めるだけでなく、正規表現が誤って検出しやすい「本物に似た非秘密情報」を重視して学習データに組み込んだ点が特徴的です。
具体的には、文書内のサンプル文字列、テストコード内のダミー値、公開鍵、チェックサム、非秘密の識別子といった、構文上は本物の認証情報と区別がつきにくいデータを学習させました。これにより、「dummy」「example」「fake」といった単語が近くにある場合や、テストファイル内に存在する場合と、本番用の設定ファイルで環境変数に代入されている場合の違いを、文脈から判断できるようにしています。
また、評価データの作り方にも配慮がなされています。データセットを学習用と評価用に分割する際、同じリポジトリ、候補値、または類似の事例を共有する行を事前にグループ化し、似通った例が学習用と評価用の両方に紛れ込まないようにしました。これにより、類似例の混入によって評価時の精度が見かけ上高く測定されてしまう事態を防ぎ、未知のコードに対する判定力を事前に検証しています。分類の閾値についても、オフライン評価で選定した上で、展開前に本番に近いトラフィックで挙動を確認したと報告されています。
GitHubが報告した効果と指標の意味
GitHubの自己報告によると、従来のLLMベースのパイプラインと比較して、コミットプッシュ後のスキャン実行時間の中央値が86%低下しました。また、顧客を対象としたA/B実験において、リポジトリ所有者で重み付けした検出結果の受け入れ指標が11.5%増加したと報告されています。
ここで示されている数値は、開発作業全体の所要時間やプッシュ前の待ち時間全体の削減率ではなく、プッシュ後のスキャン処理時間の中央値を比較したものです。また受け入れ指標の増加も、単純な検出精度そのものが11.5ポイント上昇したという意味ではありません。大量のアラートを一括で処理する一部の顧客の影響によって全体の平均値が歪むのを防ぐため、リポジトリ所有者単位で重み付けを行った結果としての11.5%増という評価です。
通知と作業中断で異なる判定基準
同じ分類器をどのタイミングで動かすかによって、求められる条件は大きく変わります。GitHubが2026年10月7日に公開した補足記事では、コミットをプッシュした後にバックグラウンドで調査用のアラートを出す処理と、プッシュそのものを遮断する処理とでは要件が異なる点が論じられています。
プッシュ後にセキュリティ担当者や開発者が確認する用途であれば、ある程度の候補を広めに拾う判定でも調査材料として有用です。しかし、プッシュ前にコードの送信を止める処理では、誤検知が発生すると開発者の作業が直接中断され、検査ツールそのものへの信頼を損ねてしまいます。そのため、作業を止める判定においては、処理遅延を極小化することに加え、誤検知を極力抑える高い確信度が求められます。
業務システムでAIを用いたチェック処理を導入する際も、「事後に一覧化して確認する処理」なのか「次の作業に進むのをブロックする処理」なのかによって、判定の厳しさや許容できる誤判定の基準を分ける視点が欠かせません。
既存の業務システムへ文脈判定を組み込む考え方
国内の業務システムや社内ツールの保守において、設定ファイルの静的解析でサンプルの接続文字列やテスト用IDまで毎回警告され、確認作業が形骸化している場面を仮定してみます。
こうした既存の検査にAI判定を取り入れる場合、いきなりすべての処理を機械学習モデルに置き換える必要はありません。まずは現行のルール抽出を維持したまま、現場で「誤検知」として無視されている文字列のパターンと、それが誤検知だと判断された周囲の文脈(ファイル名、変数名、用途の説明文など)を整理します。
その上で、無効化された検証用の文字列を用いて、本番設定・マニュアル・テストコードといった異なる文脈を再現したテストデータを用意します。候補の絞り込みは既存のルールに任せ、文脈判断だけを小型モデルや分類処理へ渡す構成を取ることで、抽出漏れのリスクと判定精度の評価を切り分けて検証できます。
また、判定結果をすぐに承認・停止のフローに直結させるのではなく、まずはログ出力や担当者への通知にとどめ、実際の運用で誤判定がどの程度生じるかを確認しながら適用範囲を広げていく進め方が現実的です。
開発・保守工程のAI組み込みについてデノフへ相談できること
既存システムのルールチェックにAIによる文脈判定を組み合わせるアプローチは、誤検知の削減と処理の安定性を両立させる有効な選択肢です。一方で、自社データをどのような形式でモデルに渡すか、誤検知と見逃しのバランスをどう評価するか、既存のCI/CDや業務フローへどう接続するかといった検討が必要になります。
デノフでは、Webサイト・業務システムの設計・開発・運用保守のサービスを通じて、業務の整理からAIを活用する業務の選定、ツール選定、導入後の定着までを一貫して支援しています。既存の検査処理の整理、判定を補助するツールの選定、通知や記録を社内システムとつなぐ連携設計、小さく試す検証範囲の具体化などでお困りの際は、デノフの相談窓口よりお気軽にお問い合わせください。