業務システムへLLM(大規模言語モデル)を組み込もうとするとき、公開ベンチマークや手元の簡単なプロンプト検証で良好な結果が出ても、いざ本番運用を想定すると判断に迷う場面が少なくありません。実際の業務入力には表記揺れやコンテキストの欠落があり、単一の精度スコアが高くても、見逃してはならない重大な例外が含まれていれば業務としての採用は難しいためです。
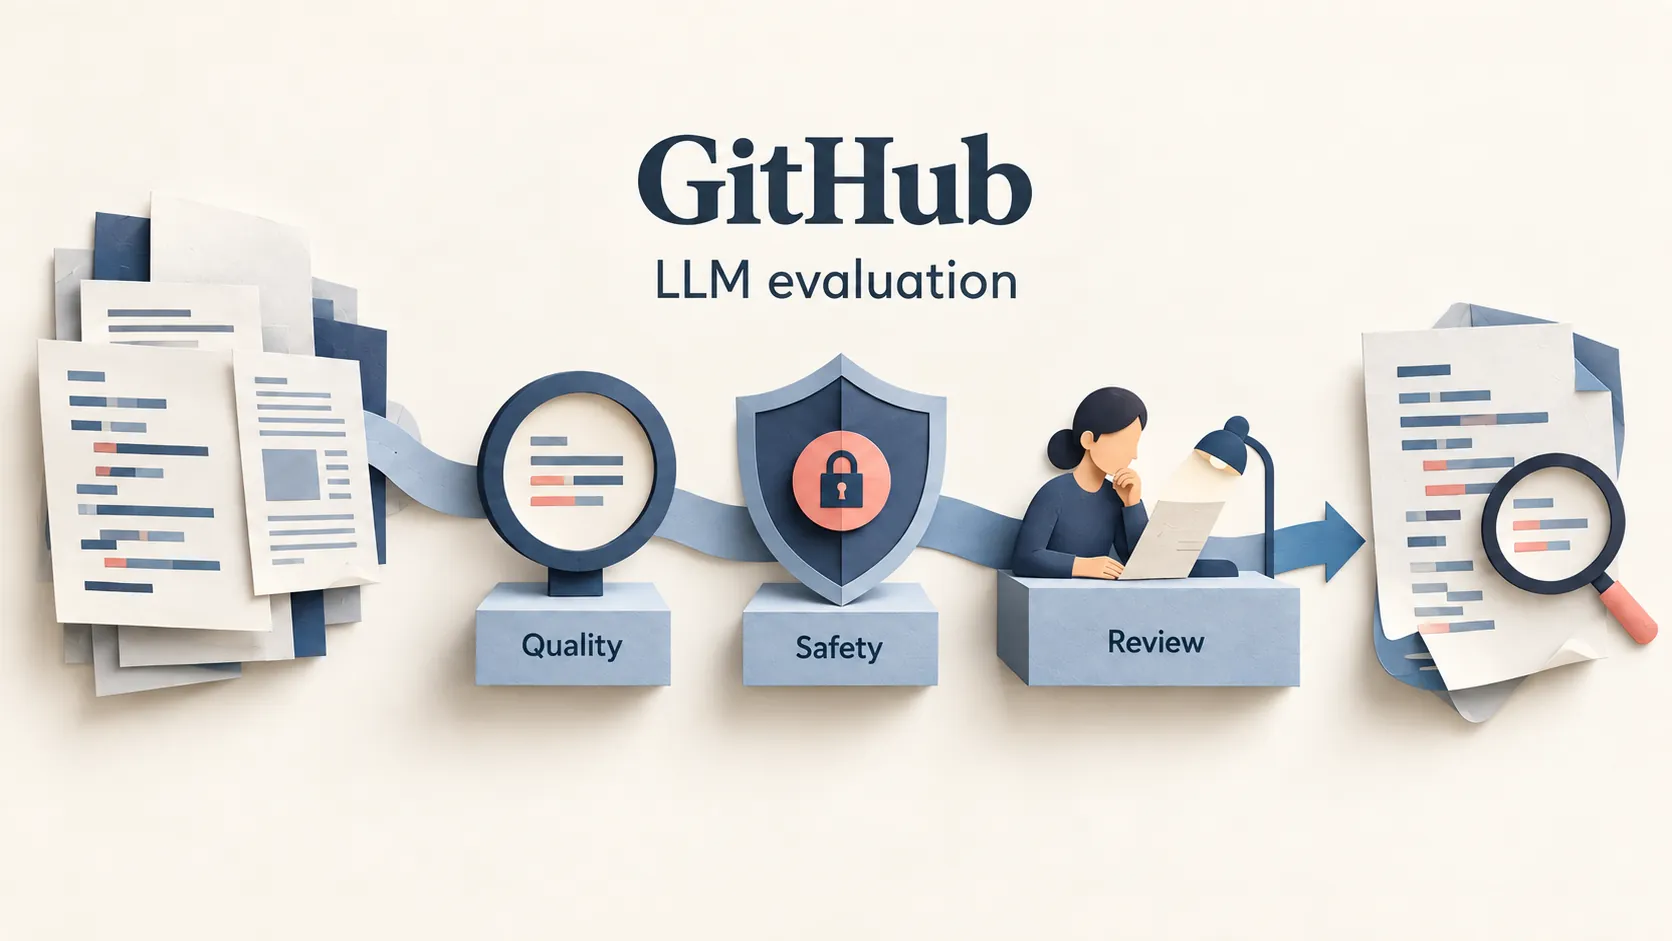
2026年8月、GitHubは公式ブログで公開した本番導入前のLLM評価手法に関する解説の中で、リポジトリ内の認証情報やキーを検知する「秘密情報スキャン」の誤検知削減を題材に、本番投入前にどのような評価基盤を整えたかを共有しました。単に「モデルが正しく判定できるか」を競うのではなく、製品や業務の意思決定を支えるための評価設計が示されています。
評価指標を「主成果」「安全制約」「運用ガードレール」に分ける
GitHubの秘密情報スキャンでは、コード中の文字列が本物の認証情報に似ているだけで実際には無害なテスト値である場合、開発者に不要な通知が届き、確認の手間が発生します。このノイズを減らすことが改善の目的ですが、誤検知を減らそうとするあまり、本物の認証情報を見逃す割合(リコールの低下)が増えてしまっては、セキュリティ機能としての根幹が揺らぎます。
そこでGitHubは、評価の指標を同列に扱わず、次の3つの階層に整理して実験を進めました。
- 主成果(Primary outcome):達成したい改善目標。ここでは不要な通知を減らすための誤検知削減と適合率の向上。
- 安全制約(Safety constraint):絶対に一定水準を下回ってはならない境界。ここでは本物の情報を見逃さないためのリコールの維持。
- 運用上のガードレール(Operational guardrails):実運用に乗せるための成立条件。応答速度(レイテンシー)、利用コスト、システムの信頼性、既存基盤との互換性。
この枠組みにより、「誤検知は大幅に減ったがリコールの許容ラインを割り込んだ構成」は不採用とし、「誤検知の削減幅は堅実だが安全基準と応答速度を確実にクリアした構成」を前進させるといった、トレードオフを明確にした判断が可能になります。
オフライン評価を結合テストのように運用する
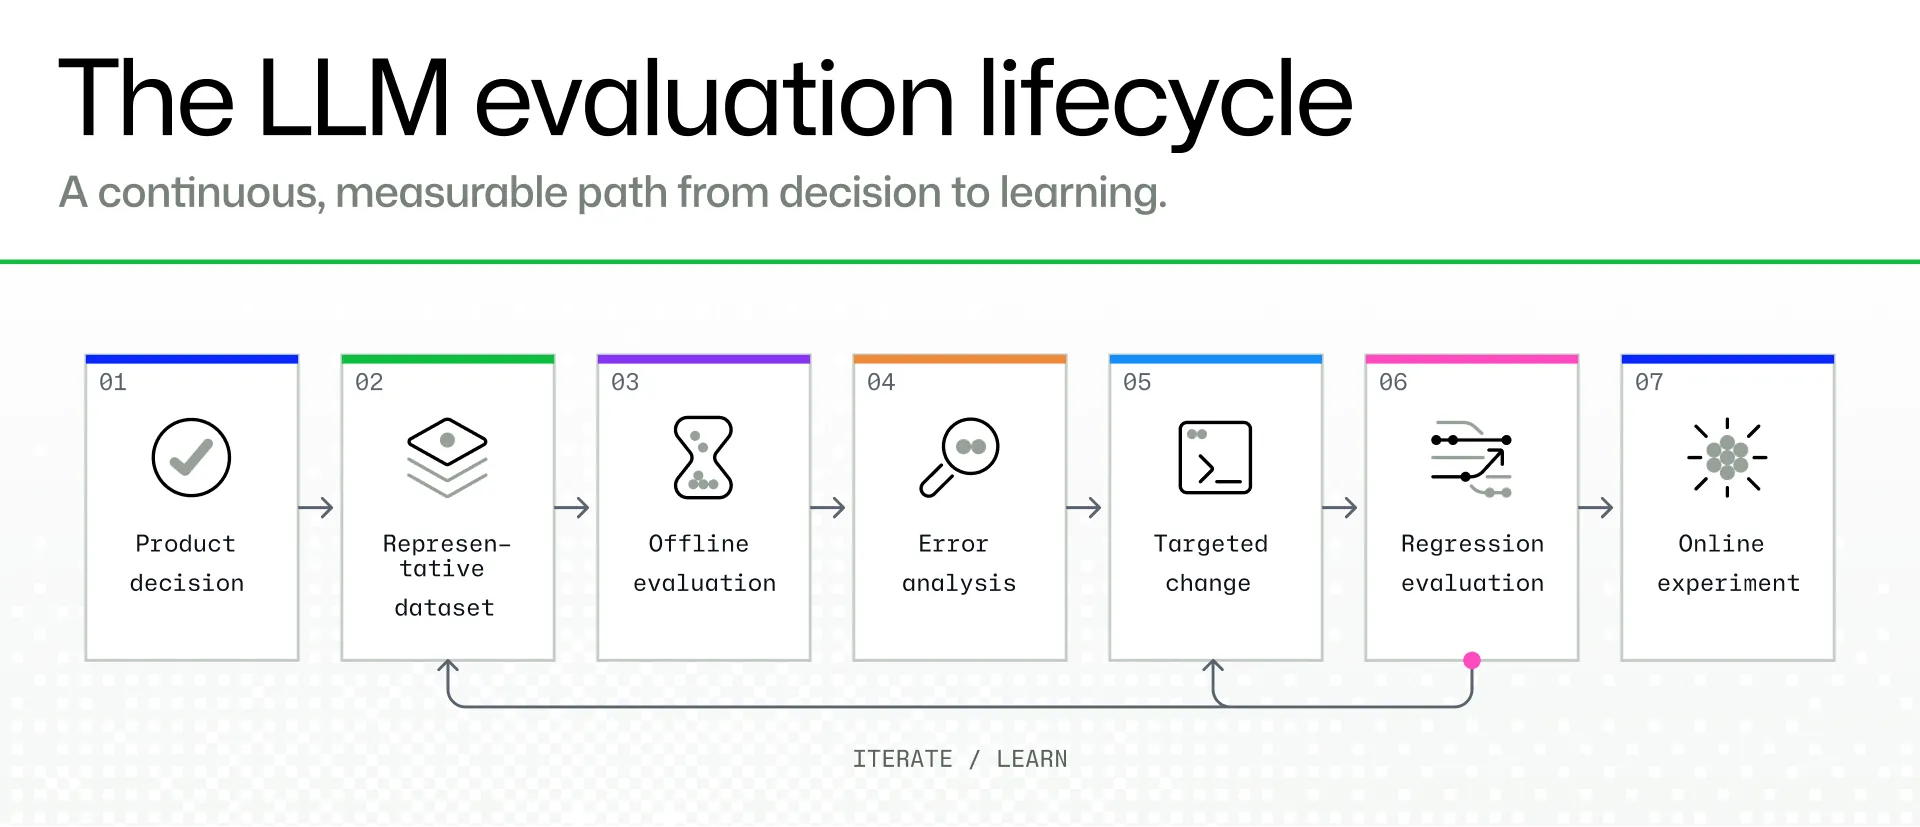
LLMを組み込んだ処理系は、プロンプトの調整、モデルの切り替え、入力文脈の加工、前後の業務ロジックの修正など、運用の過程で継続的に変更が加わります。GitHubでは、評価を一過性の作業にせず、結合テストのように変更のたびに再実行できる体制を整えました。
その際、複数の要素を同時に変えず、プロンプト変更とモデル更新を個別に実行して既知のベースラインと比較する規律を設けています。プロンプト、モデル、データセットのバージョン、周辺ロジックの構成を記録しておくことで、どの変更が適合率の改善やレイテンシーの悪化をもたらしたかを明確にし、問題が起きた際に安全に差し戻せる状態を保ちました。
また、評価用データセットが本番とかけ離れた綺麗なデータだけだと、実環境で失敗しやすくなります。GitHubの事例でも、評価対象の文字列だけでなく、周辺のコードや変数名といったノイズも含めた形で評価データを構成しています。たとえばドキュメント用のサンプル文字列が近くにあるだけで、モデルがそちらに引きずられて誤判定を起こすような実環境特有の曖昧さを、評価環境にあらかじめ含めておく重要性が指摘されています。
なお、GitHubは評価済みのオフラインデータセットにおいて、定義したリコールのガードレールを維持しながら誤検知を95%削減したと自己報告しています。ただし、この評価で使われたデータセットの件数や詳細な構成、リコールの具体的な許容数値は原典では公開されていません。この結果は本番環境での効果を一般的に証明するものではなく、オフラインの評価基盤を通じてリスクと制約を可視化し、次の段階であるオンライン実験へ進むための判断材料が得られたという段階を示しています。
失敗を分類し、ツール連携の権限設計へつなげる
評価結果が目標に届かなかった場合、単にプロンプトを長く書き直すだけでは本質的な改善にならないことがあります。GitHubの実践では、誤判定が発生した原因を「モデルの能力」「プロンプトの指示」「入力コンテキストの欠落」「前後のパイプライン」「評価データのラベル」といったカテゴリに分類し、どこに手を打つべきかを切り分けるエラー分析を重視しています。
さらに、AIに判断だけでなく外部ツールの呼び出しやシステム操作を担わせる場合は、精度の評価と並行して実行権限の制御が欠かせません。たとえばGitHubが公開したGitHub Copilot SDK for Javaの解説でも触れられているように、開発環境で用いられる全自動承認の権限設定のまま本番へ持ち込むのではなく、エージェントセッションごとにどのツールの呼び出しを許可するかを厳格に検証するポリシーの実装が求められます。評価によってモデルの挙動を確かめることと、想定外の動作を防ぐ権限境界を引くことは、本番導入の両輪です。
自社の既存業務へ応用するための考え方
この評価アプローチは、セキュリティ業務に限らず、社内の確認・審査業務へAIを組み込む際にも応用できます。たとえば、社内申請で提出された添付書類をAIが一次確認し、判断が難しい申請だけを担当者へ振り分ける業務を想定してみます。
この場合も、「書類の不備を自動で指摘して確認の手間を減らすこと(主成果)」だけを追うと、本来却下すべき重大な不備を見落とす恐れがあります。「見落としてはならない重大な不備の検知率(安全制約)」を定め、処理時間やAPI費用(運用条件)と合わせて基準を設けることで、どこまでをAIに任せてどこからを人の確認に残すべきかの境界が明確になります。
自社で準備を進める際は、まず次の点から整理を始めるのが現実的です。
- 現在の確認業務で、AIによって減らしたい作業負担と、絶対に見逃せない事象を切り分けて書き出す。
- 実際の業務データから、判断に迷いやすい曖昧な案件や例外的な入力パターンを抽出しておく。
- プロンプト、利用モデル、入力形式、前後のルールを変更した履歴を記録し、同じ条件で比較できるようにする。
個別の業務データ連携や監査ログの保管要件、既存システムとの接続仕様は企業ごとに異なるため、標準機能で対応できる範囲と専用の開発が必要な領域をあらかじめ見極める必要があります。
業務整理とシステム連携のご相談
AIの導入判断を前に進めるためには、モデルの選定に入る前に、対象となる業務フローのどこにAIを配置し、何を評価基準とするかを定義することが近道です。
デノフへのご相談では、既存業務へのAI組み込みにおいて、守るべき安全条件や評価観点の整理、人が確認を行う境界の設計、既存システムとの連携範囲の具体化について検討を進めることができます。業務フローの整理や判定結果の扱いについて検討したい場合は、デノフのサービス案内をご覧いただくか、デノフへの相談窓口よりお気軽にお問い合わせください。