ソフトウェア開発の現場でAIを活用する際、より性能の高いモデルを単一で使い続ける運用は、API利用コストの肥大化や応答待ち時間の増加といった壁に直面しがちです。一方で、難度の高いタスクを軽量なモデルだけに任せると、変更内容の不備や誤修正のリスクが高まります。
こうした課題に対し、GitHubは2026年9月4日、複数提供者のモデルを実行時に動的オーケストレーションする研究プレビュー「Project HydraFusion」を発表しました。公表されたGitHubによるProject HydraFusionの解説によると、発表時点ではGitHub Copilot CLIの /experimental 経由で、すべてのCopilotプランの利用者に提供されています。利用量は呼び出された各モデルが消費したトークンに応じた標準レートで計算されます。なお、研究プレビューとしての提供であるため、利用状況やフィードバックに応じてモデル構成やワークフロー、提供条件などは今後変更される可能性があると説明されています。
単独実行・段階的昇格・独立レビューを使い分ける3つのパターン
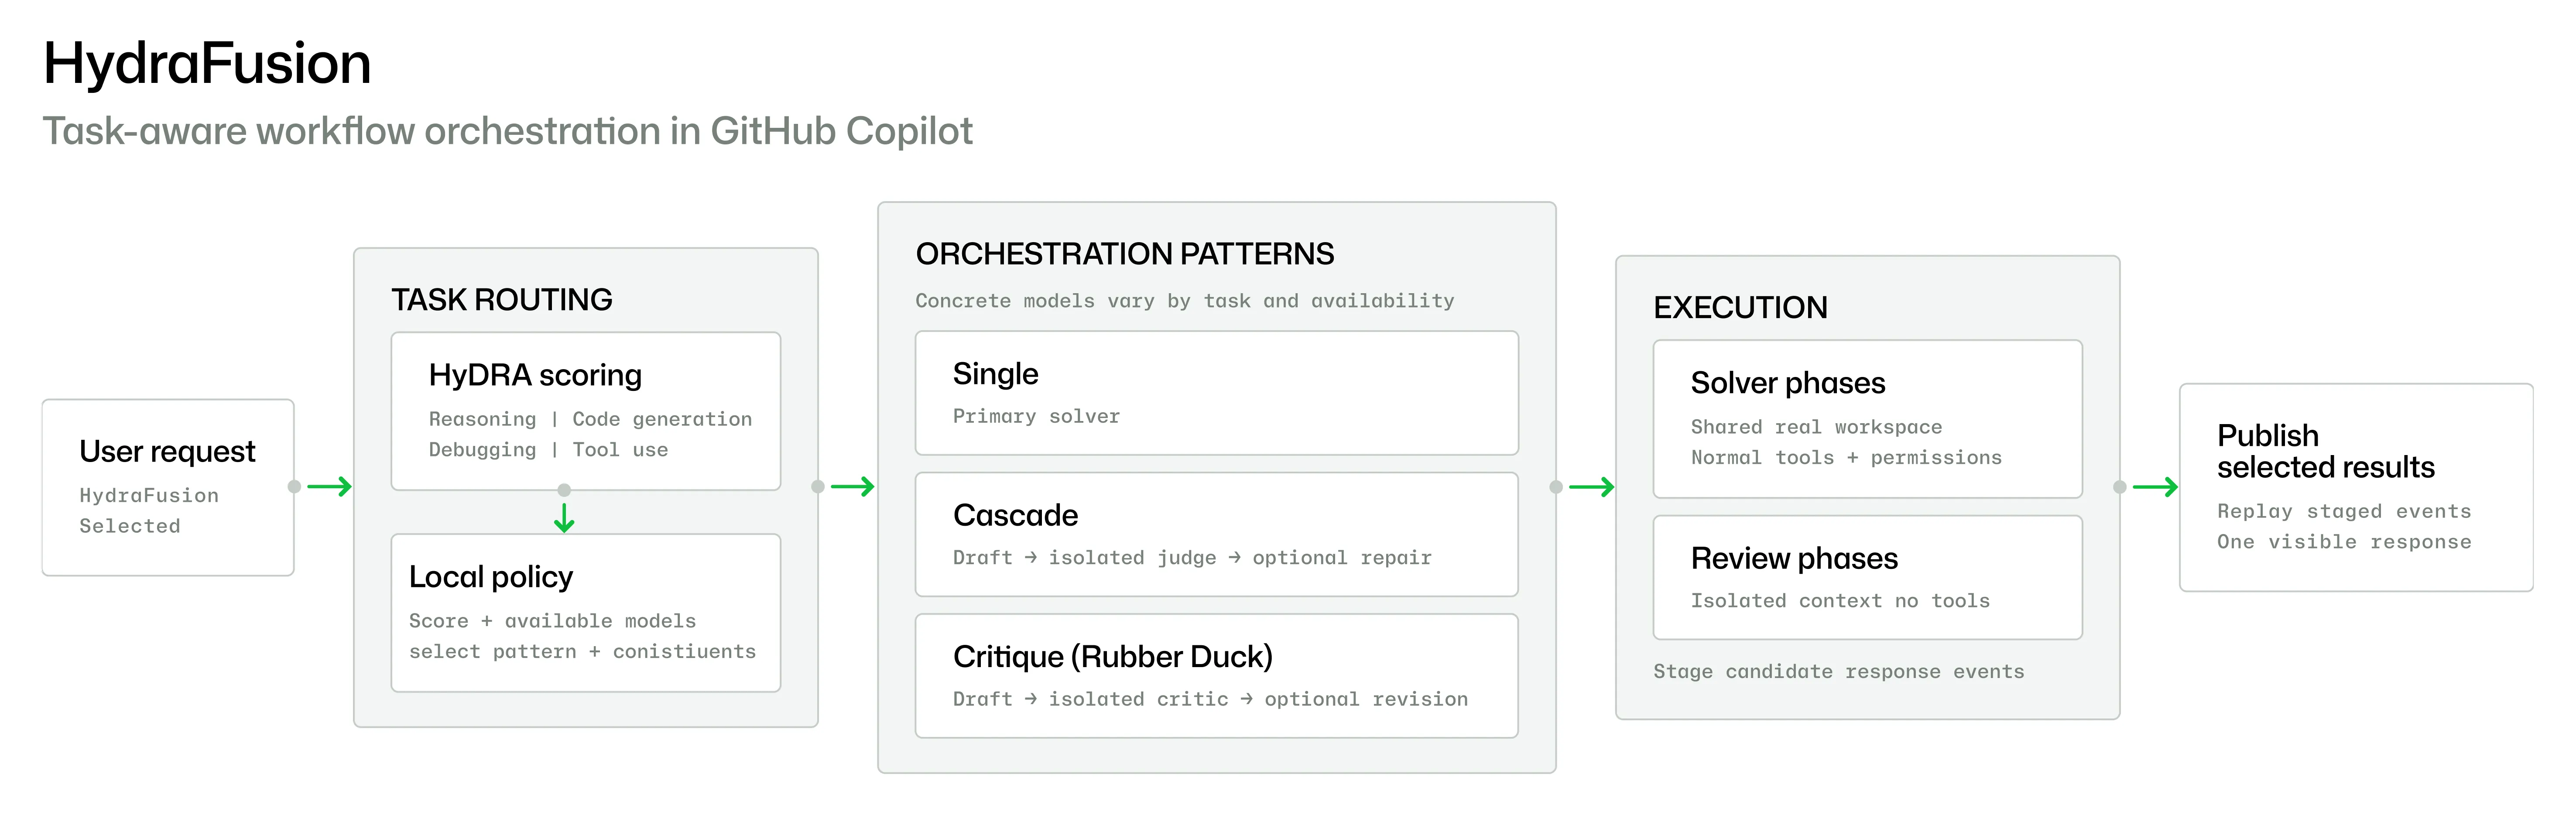
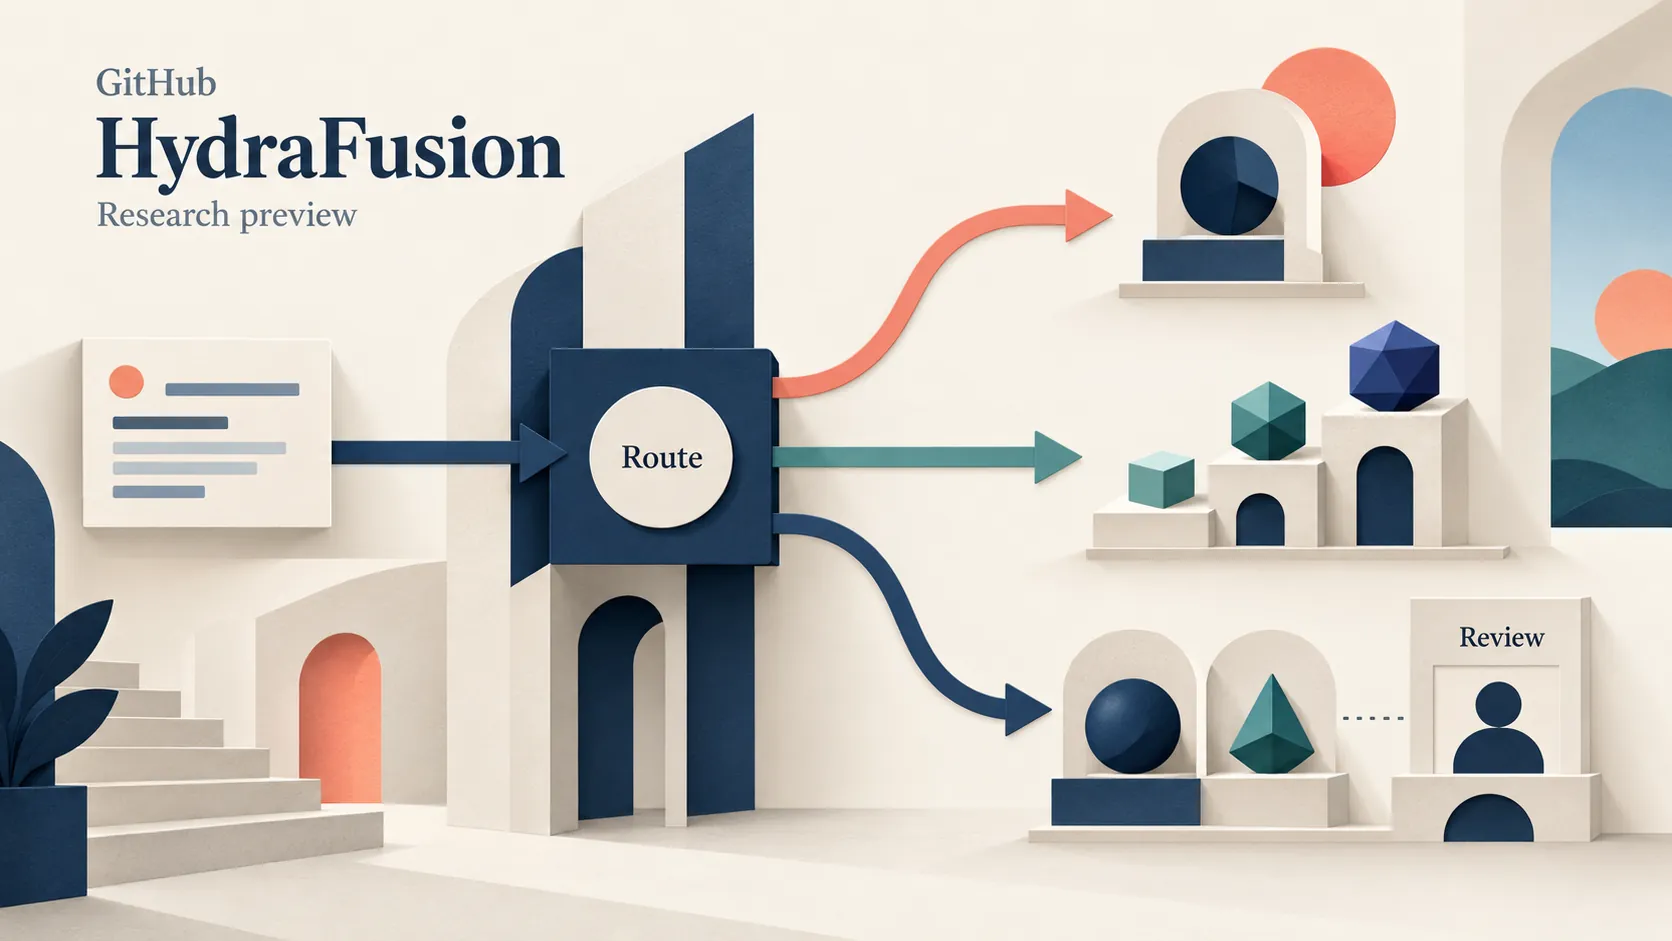
HydraFusionの大きな特徴は、すべての要求に対して画一的な多段推論を行うのではなく、要求の性質や難度に合わせて実行パターンを選択する点です。具体的には、次の3つの実行パターンが用意されています。
- Single:選択された1つのモデルが直接タスクを解決するパターンです。単一のモデルで直接解決できるタスクにおいて、速度と効率性を維持します。
- Cascade:まず効率的なモデルが解決策のドラフトを作成し、設定された品質ゲートの判定を通過できない場合にのみ、より強力なモデルへ処理を昇格(エスカレーション)させます。
- Critique:ドラフト作成を担当したモデルとは異なる系列のモデルが、ツールを持たない読み取り専用の批評役としてレビューを行い、そのフィードバックをもとに作成役が1回だけ修正を加えます。
すべての処理を複雑なマルチエージェント協調に流すのではなく、追加のモデル呼び出しが品質向上に寄与する見込みがある場合に限定して昇格や批評を挟む設計は、費用と応答速度の無駄を防ぐ上で実務的にも参考になります。
変更役とレビュー役を切り離す5つの運用原則
リポジトリ規模のコード変更をAIに委ねる場合、モデルの生成精度だけでなく、安全にコードベースへ反映させるための仕組みが不可欠です。GitHubの解説では、信頼性を担保するための5つの運用原則が挙げられています。
- 完全な利用集計(Complete accounting):ドラフト作成、批評、修正、昇格、再試行、フォールバックを含むすべての工程でトークン消費と費用を集計します。
- 実行境界の限定(Bounded execution):各工程に明示的なタイムアウトとキャンセル動作を設定し、予期せぬループや費用の暴走を防ぎます。
- 隔離されたレビュー(Isolated review):変更を担当するエージェントが共有ワークスペースと権限管理されたループで動作するのに対し、レビュー役はツールを持たない隔離コンテキストで実行されます。これにより、批評役が誤ってコードを書き換えるリスクを排除します。
- 失敗時の適用停止(Fail-safe application):処理が途中でキャンセルされた場合や検証に失敗した場合には、リポジトリにパッチを一切適用しません。不完全な変更が残ることを防ぐ防護策です。
- ルーティングの事前検証(Validated routing):実行前にワークフロー定義、モデルの割り当て、フォールバック動作、モデルの可用性を検証します。
また、開発者へのフィードバック表示においては、途中のドラフトがレビューや修正、破棄の対象になり得ることから、未完成な作業が確定したものと誤認されないよう、途中のドラフトは表示せず一貫した結果として返す方針がとられています。そして、処理がキャンセルされたり検証に失敗したりした場合にはパッチを適用しないことで、不完全な変更がリポジトリに残ることを防ぐ構成としています。
ベンチマーク評価値と実務への適用前提
GitHubが公表したオフライン評価は、Claude Opus 5(およびGPT-5.6 Sol)を比較対象とし、同一のタスク入力、ツール、実行制限、価格前提、採点条件、未取得結果の扱いのもと、すべてmedium reasoningの推論強度で実施されました。ここで測定された品質指標である「検証済みタスク品質」は正答と確認されたタスクの割合であり、「推定費用」にはドラフト作成、批評、修正、昇格、再試行、フォールバックまでを含めたワークフロー全体のトークン消費が集計されています。
この条件下で、ターミナル環境での複合タスクを評価するTerminalBench 2.1において、Opus 5比で検証済みタスク品質が4.9ポイント高く、推定費用は67%低いと報告されています。一方で、大規模コードベースの修正を扱うDeepSWEでは品質が1.5ポイント低く推定費用は36%低い、実際のセッションに基づくCheckpointBenchでは品質が0.1ポイント低く推定費用は65%低いという結果でした。
ただし、これらの数値は特定のベンチマーク改訂版、固定されたワークフロー構成、同一の推論強度という制御されたオフライン評価の結果です。GitHub自身も、実際の開発ワークロードでどのような結果になるかは研究プレビューを通じて検証を深める段階にあると述べています。
さらに、現時点の研究プレビューで推奨されているタスク範囲は、1回のプロンプトで完結する十分にスコープが明確なコーディングタスクです。反復を繰り返す長いセッションでのマルチターン性能は今後の検証対象とされており、あらゆる実務タスクへ一般化できる段階ではありません。公表数値をそのまま個々の現場における生産性向上や費用削減の保証と捉えるのではなく、タスク特性によって費用と品質のバランスが大きく変動するという前提を把握しておく必要があります。
モデル判断を過信せず、外部送信データと費用を制御する
AIモデルをレビューや検査の工程に組み込む際には、モデルの振る舞いとデータ境界の設計も欠かせません。この点については、GitHubが自社のアクセシビリティスキャナーにモデルを組み込んだ際の知見をまとめた代替テキストの品質検査に関するGitHubの解説記事が参考になります。
この記事では、正規化文字列の一致などルールベースで確定的に判定できる検証は既定で実行し、前後の文脈理解を要するモデル判断は利用者が選択するオプトイン形式に分ける方針が説明されています。また、外部モデルへWebページのデータを送信する際、URLに含まれる認証トークンやセッション情報などのクエリ・フラグメントを除外し、不要な画像属性を省略するデータ保護の工夫が紹介されています。
さらに、モデルによる指摘は「確定的な合否判定」ではなく「人間の注意を促すレビュー」として位置づけられています。画像ごとにモデルを呼び出すと費用が跳ね上がるため、コミットごとの自動実行ではなく定期的なバッチ実行に留めるといった運用の工夫も示されており、日常の開発フローにAIを組み込む際の現実的な境界設計と言えます。
既存の開発業務へ段階的に取り入れるアプローチ
国内の企業が自社の開発・運用業務に複数モデルの考え方を取り入れる場合、いきなり全面的な自動化を目指すのではなく、権限と検証の境界を段階的に定義することが現実的です。
たとえば、社内業務システムの小規模な改修依頼を扱う仮定のフローを考えてみます。まず、変更候補のコード作成をAIに任せ、次に変更権限を持たない隔離環境で別のモデルによるチェックを行わせます。そして、既存のユニットテストをパスし、担当エンジニアがレビュー承認を行って初めてリポジトリへ統合するという手順を踏みます。
自社でまず着手できることとしては、次の3点が挙げられます。
- タスクの切り分け:日々の改修依頼を、単独のモデルで完結できる直接的な作業と、追加のレビューや検証ゲートを要する複雑な作業に分類する。
- 取り扱うデータの制限:AIへ送信するリポジトリ情報や設定ファイル、ログから、機密情報や認証情報を適切に除外するルールを定める。
- 安全な中断ルールの設定:キャンセル時や検証失敗時にはリポジトリへパッチを適用しない仕組みと、人間が必ず確認すべき通過条件を明確にする。
開発フローに合わせた実行境界の設計相談
AIを使った開発支援を現場に定着させるためには、単に高精度なモデルを選択するだけでなく、既存のシステムや開発手順に合わせた「変更権限」「レビューの役割」「テスト・承認ゲート」の設計が鍵となります。どの処理をAIに任せ、どの判断を人間のエンジニアに残すかという境界が曖昧なままでは、手戻りやセキュリティ上の懸念が残ってしまいます。
デノフでは、AIを組み込む対象業務の選定や、既存の開発環境・業務システムとの安全な連携範囲の整理、検証手順や人間によるレビューを前提とした運用設計の相談をお受けしています。具体的な支援内容についてはデノフのサービス案内をご覧いただき、自社の開発フローに合わせた導入方針をご検討の際はデノフへの相談窓口よりお気軽にお問い合わせください。