ソフトウェア開発の現場において、AIエージェントを活用したコード修正やテストの自動生成を取り入れる動きが急速に進んでいます。しかし、複数のエージェントが同時に作業を行い、高頻度で変更を送信するようになると、従来の開発基盤や継続的インテグレーション(CI)のパイプラインがその負荷を支えきれなくなる場面が生じます。
2026年10月6日、GitHubは公式ブログでAIエージェント時代の大規模開発に向けたGit基盤の再設計方針を公表しました。数千のエージェントが自律的にコミットを繰り返す環境では、単に読み取り性能を補強するだけでは解決できない書き込みや競合の制約が顕在化します。この記事では、GitHubが示した設計思想を手掛かりに、開発現場で生じる待ち時間の構造と、既存の開発環境を整理するアプローチを考えます。
エージェント規模の開発が突きつける「書き込み」の限界
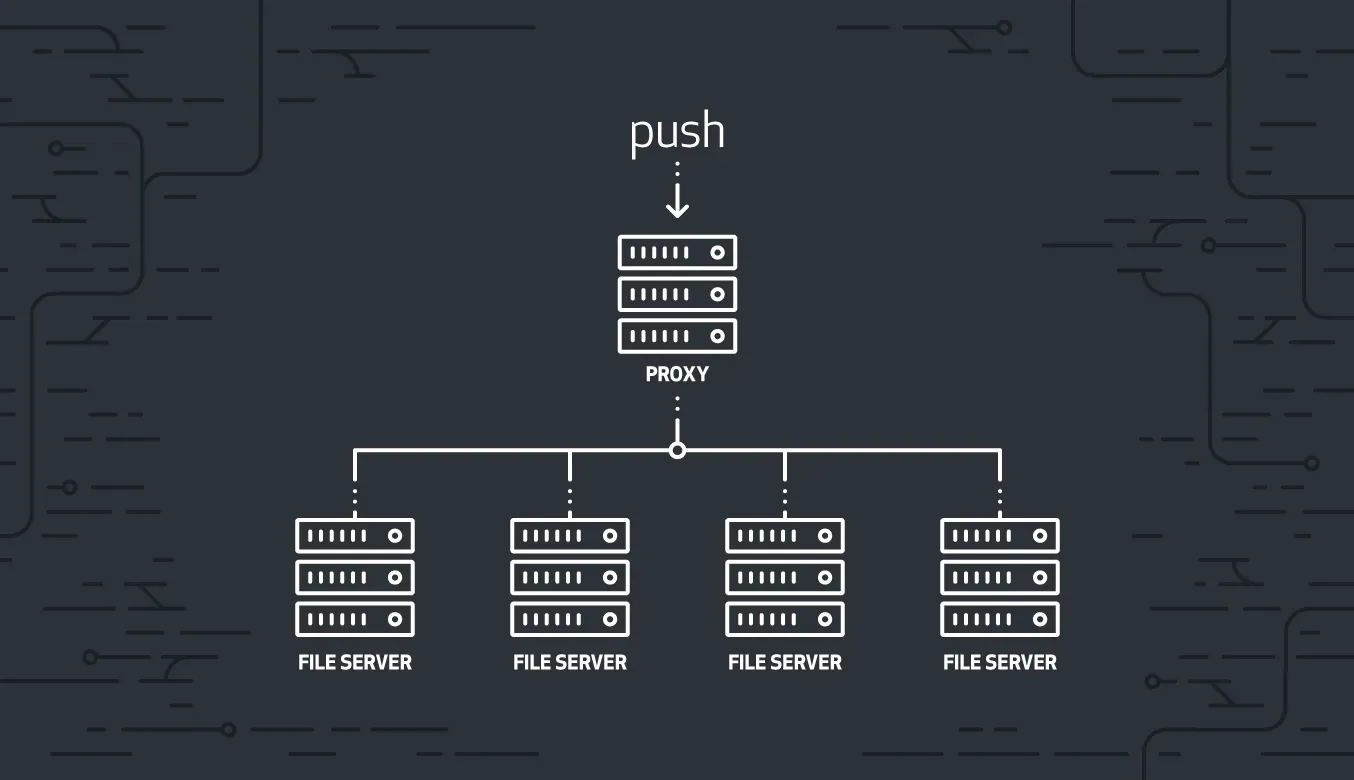
AIエージェントによる開発では、人間とは異なるパターンで基盤に負荷がかかります。エージェントは細かな変更ごとに即座にコミットやプッシュを行うため、プッシュ完了までのわずかな遅延がそのまま作業全体のボトルネックになります。また、多数のエージェントが個別のブランチで並行作業を進めても、最終的なマージ処理は単一のブランチ(参照)に集中します。さらに、一度のプッシュを契機として、CIや静的解析などの読み取りリクエストが大量に発生する構造です。
GitHubの説明によると、長年利用されてきた同社のストレージ基盤「Spokes」では、ローカルディスクを持つ複数台のファイルサーバー(標準で5台)にリポジトリの完全な複製を保持し、分散合意プロトコルによって整合性を維持してきました。この構成では、読み取りの負荷を下げるためにレプリカを追加すると、すべてのレプリカが書き込み処理に参加する必要があるため、もっとも応答の遅いレプリカに引きずられて書き込み全体の性能が低下するという構造的な制約がありました。
プッシュを安全に保存し、後続のCIや別のエージェントから一貫した状態として参照できるようにする「書き込み処理」は、単にキャッシュを前段に並べて解決できる読み取り処理とは異なり、容易にはスケールしません。読み取りと書き込みの結合が、高頻度な並行処理における天井となっていました。
過去のSpokesにおける内部更新の集約と優先処理
変更の送信がさらなる内部処理を呼び出す問題は、過去にも形を変えて経験されています。GitHubが2017年に公開したSpokesの広域分散に関する解説記事では、利用者がプルリクエスト(PR)のブランチへプッシュした際の記録や同期に加え、masterブランチへプッシュされた際に、対象となるアクティブなPRごとにテスト用マージやリベースを計算して参照を作成する挙動が紹介されていました。
同記事によると、一部のリポジトリではmasterへの更新が100以上の内部参照更新を一斉に誘発し得るとされました。もしそうした内部更新の処理が利用者の更新を阻害すれば、リポジトリが約30秒間占有され、利用者の要求が大きく遅延したりタイムアウトしたりしかねない懸念が示されています。GitHubはその対策として、事務的な内部更新の一部をまとめて少ないトランザクションに集約し、即時性を要しない内部処理よりも利用者が明示的に起こした更新を優先して処理する工夫を取り入れました。この歴史的な経緯は、基盤全体の刷新にとどまらず、「更新に伴って誘発される処理をどう集約し、優先度をどう制御するか」が待ち時間の短縮において重要であることを示しています。
調整の最小化と、ストレージとコンピュートの分離
今回GitHubが示した新しいアーキテクチャは、既存のブランチ運用、コードレビュー、マージ、履歴管理といった開発フローを維持したまま、並行処理能力を大幅に引き上げることを目指しています。その中心となる方針は「調整の最小化」と「ストレージと処理の分離」です。
第一に、プッシュ処理において合意が必要な範囲を「参照(ブランチの指す位置)の更新」だけに絞り込みました。背後にあるGitオブジェクトの保存、接続関係の検証、秘密情報のスキャンといった重い作業については、その多くを他の書き込みと並行して進められる設計方針へと改められています。さらに、これまでリクエスト処理と同じサーバー上で動いていたリポジトリの圧縮や不要オブジェクトの削除といった重い保守処理を、耐久ストレージに対して別ワーカーが非同期で実行する構成へと切り離しました。
第二に、正本データを高耐久なオブジェクトストレージ(Azure Blob Storage)に預け、Gitリクエストを処理する計算層を軽量なキャッシュワーカーとして独立させました。これにより、CIによる大量のクローンや読み取りスパイクが発生しても、耐久レプリカを増やすことなくワーカーの追加で読み取り能力を確保でき、各プッシュに余計な書き込み負担を加えずに済む設計としています。GitHubはこの新アーキテクチャについて、内部ベンチマークで書き込みスループットが最大35倍に達したと報告しています。ただし、これは内部測定の自己報告であり、現在も基盤の再構築が進められている段階で、一般的な全利用環境への適用完了時期が示されているわけではありません。
国内の開発現場で考える、待ち時間と重複処理の整理
GitHubの大規模な内部基盤の再設計をそのまま自社システムへ持ち込むことは現実的ではありませんが、その根本にある「順序を守るべき処理と、並行・非同期で進められる処理を分ける」という視点は、国内のシステム開発や保守の現場でも有益です。
たとえば、受注管理システムなどの社内業務アプリケーションにおいて、開発者が手作業で改修を行う傍らで、AIエージェントが定常的なリファクタリングやテスト追加のブランチを並行して作成する場面を想定してみます。ブランチの数やプッシュの回数をむやみに増やしていくと、次のような箇所で待ち時間が発生しがちです。
まず、プッシュのたびにフルスペックのCIが重複して起動し、ビルドや統合テストの実行枠が枯渇することがあります。また、同じ親コミットから分岐した複数のブランチが同時にマージを試み、マージ待ち行列やコンフリクト解消のための再実行が頻発することもあります。これらを改善するには、基盤の性能を疑う前に、既存の記録をもとにボトルネックを可視化することが実践的な第一歩となります。
具体的には、変更のプッシュ、CIの開始と完了、レビュー完了、本線へのマージといった各工程の時刻を既存のログから確認し、待ち時間がどこに滞留しているかを調べます。軽微なドキュメント修正やテストコードの追加に対して重いエンドツーエンド(E2E)テストが都度起動していないか、同一のPRに対する連続プッシュで先行ジョブがキャンセルされずに無駄にキューを占有していないかなど、起動条件や依存関係を点検します。そのうえで、必要な検証品質と承認フローを維持したまま、軽量な検証ジョブの先行実行やバッチ的な統合など、影響範囲の小さいところから挙動の変化を比較検証していきます。
業務の整理から始める開発工程の改善
AIを活用した開発や運用の自動化を進める際、生成されるコードの量や実行速度だけに目を向けていると、その受け皿となるバージョン管理や検証環境の制約によって、チーム全体の開発テンポが停滞してしまうことがあります。どこで処理が待たされ、どの処理が重複して動いているかを正しく見極めることが不可欠です。
株式会社デノフでは、Webサイト・業務システムの設計・開発・運用保守サービスを提供しており、業務の整理からAIを活用する業務の選定、ツールの選定、導入後の定着までを一貫して支援しています。開発や保守の現場において、AIを用いた作業を取り入れる際の業務フローの整理や、既存のCIパイプライン・変更管理工程における待ち時間の切り分け、自動化を組み込む改修範囲の検討など、具体的な課題の整理段階からご相談を承っています。
自社の開発環境で並行処理やCIの実行待ちが目立ち始めた際や、AIを安全かつ効率的に組み込むための開発プロセスの見直しを検討される場合は、デノフへの相談窓口よりお気軽にお問い合わせください。