長いシステム指示がもたらす推論負荷とShopifyの取り組み
社内業務やサービス向けにAIエージェントを構築する際、振る舞いの制御規則やツールの定義、出力フォーマットの指定などをシステムプロンプトに集約することがよくあります。しかし、固定の指示文が長くなるほど推論時の計算負荷が高まり、応答開始までの時間やシステム全体の処理能力に影響を及ぼします。
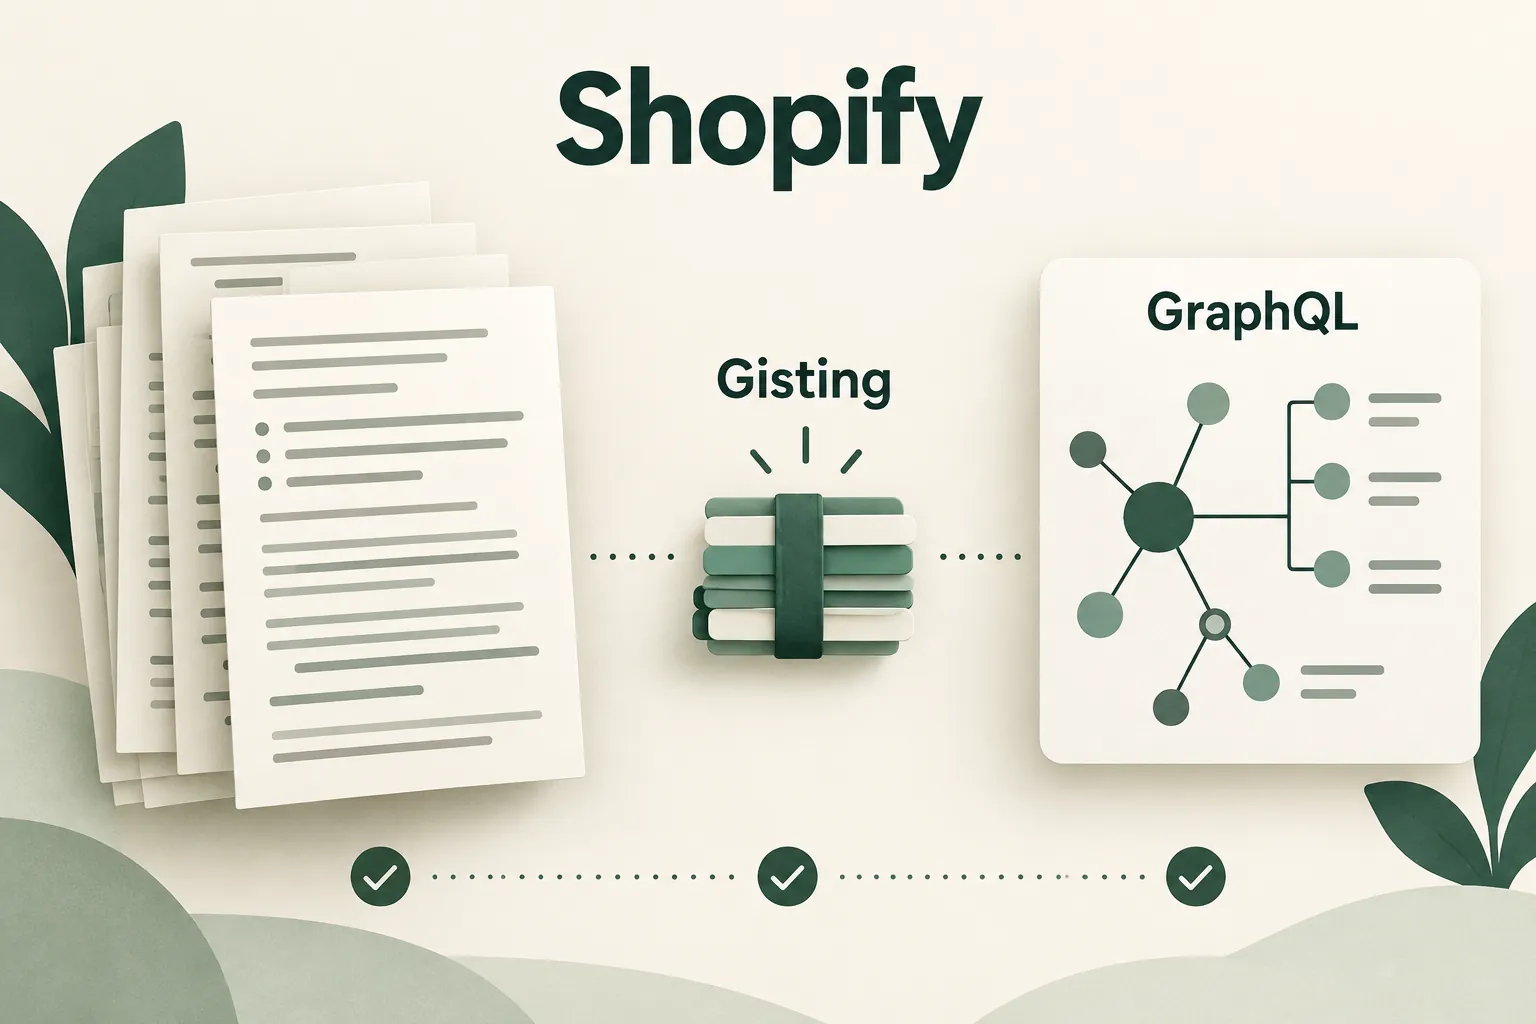
Shopifyは、自社のGraphQLエージェント「Sidekick」において、約6,000トークンあった固定システムプロンプトを約1,500個の「gist token」へと圧縮(4対1の圧縮比)した技術報告をGisting: Compressing LLM Agent context to ↑ throughput and ↓ cost (2026) - Shopifyで公開しました。指示文を短く要約して書き直すのではなく、モデル自体の語彙に特殊なトークンを追加し、元の長いプロンプトを与えられたときと同じ振る舞いを再現できるように埋め込み(embedding)を学習させるアプローチです。
重みを固定した知識蒸留とキャッシュ技術との併用
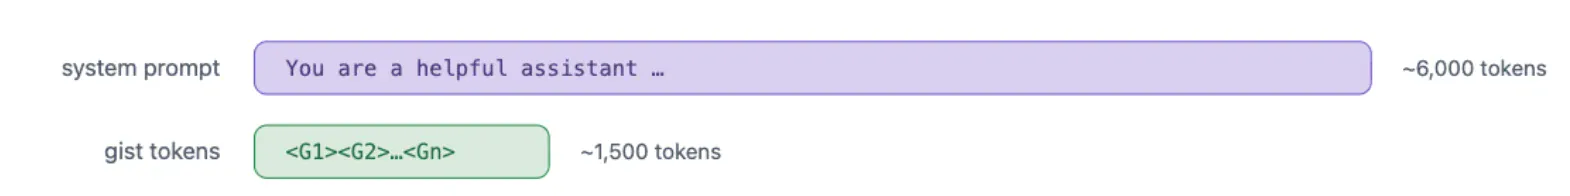
Shopifyが採用したgistingの大きな特徴は、大規模言語モデル本体の重みを更新せず、固定したまま学習を行う点にあります。学習時には知識蒸留の手法を用い、通常の自然言語プロンプト全体を入力した教師(teacher)の出力確率分布と、プロンプトをgist tokenに置き換えた生徒(student)の出力確率分布の差(KLダイバージェンス)を最小化するように、特殊トークンの埋め込みベクトルだけを最適化します。
推論エンジン側では、過去に入力されたトークン列の計算結果を保持するprefix caching(プレフィックスキャッシング)が広く使われています。ただし、Shopifyの説明によると、prefix cachingは事前計算の再利用には有効なものの、モデルが1トークンずつ回答を生成するデコード段階では、キャッシュされたすべてのキー・バリュー情報に対するアテンション計算とメモリ読み出しが依然として発生します。gistingによって系列長そのものを4分の1に短縮することで、デコード時のメモリ帯域負荷を大幅に削減でき、キャッシュ機能と組み合わせることで相乗的な効果が得られるとしています。
Shopifyが報告した350 RPM(毎分リクエスト数)の負荷試験結果によると、中央値の初速応答時間(Time to First Token: TTFT)は438ミリ秒から354ミリ秒へ短縮され、リクエスト完了までの中央値遅延は6.8秒から4.2秒へと改善しました。さらにスループットは毎秒20.2クエリから23.4クエリへと向上したとされています。また、実運用のワークロードにおいても、同社のGraphQLトラフィックを処理するハードウェア構成でGPU数を14パーセント削減できたと報告されています。なお、これらの数値は同社の特定モデル、ハードウェア構成、およびリクエスト負荷の下で測定された自己報告値であり、あらゆる環境で同じ改善幅が得られるわけではありません。
圧縮の前に不可欠となる品質評価の設計
プロンプトの圧縮を検討する際、単にレイテンシーや計算コストの削減率だけに注目すると、業務に必要な回答精度や安全性が損なわれる危険があります。Shopifyが公表している関連資料Sidekick's continual learning loop (2026) - Shopifyでは、モデルの最適化や継続学習を進める大前提として、評価基準の確立を最重要視しています。
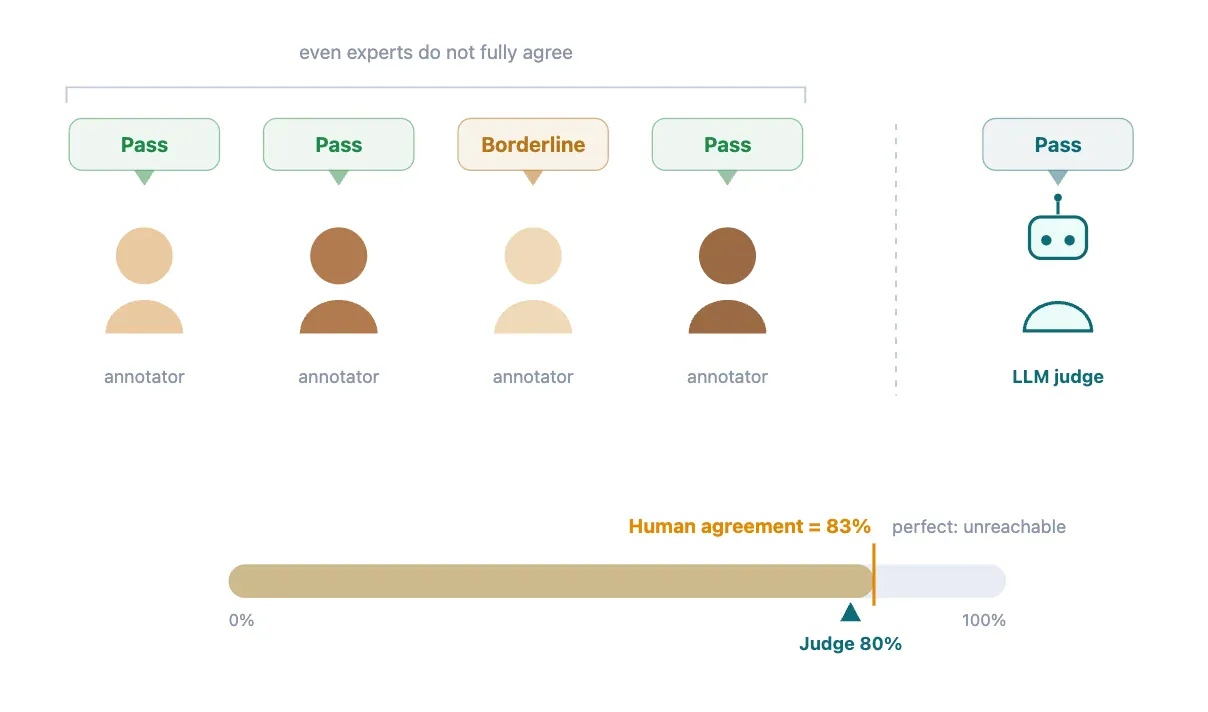
具体的には、回答の網羅性、実行の正確さ、文章の品質、安全性といった観点を点数化する評価基準(ルーブリック)を定義し、あらかじめ選ばれた模範例だけでなく、実際のトラフィックから無作為に抽出したデータを用いて検証しています。さらに、専門の評価者2名による採点の一致度をコーエンのカッパ係数などで測定し、評価基準自体に曖昧さがないかを検証した上で、自動評価の仕組みを整備しています。一方、gistingの実装報告では、複数の圧縮比を実験して予測品質が劣化し始める境界を見極めることで、対象領域の複雑さに応じた最適な比率(この事例では4対1)を選定したと説明されています。このように客観的な品質評価の基準を持つことが、圧縮の可否や比率を判断する上で不可欠な要素となります。
社内業務AIへの応用と性能評価の進め方
この事例の考え方は、日本の企業における業務向けAIの運用改善にも示唆を与えています。たとえば実在の導入事例ではありませんが、社内の商品情報や在庫データを検索するAIアシスタントにおいて、毎回決まった社内規定やAPIの検索手順、回答形式を長いシステム指示として読み込ませている場面が考えられます。利用頻度が高まるにつれて応答の遅れが目立ち始めた場合、固定指示の圧縮や最適化が有力な検討対象になります。
ただし、Shopifyが実施したgist token方式には、モデル語彙への特殊トークン登録や埋め込みの学習、推論時の置き換えといった機能の実装が含まれます。利用しているモデル提供者や推論環境においてこうした特殊トークンの学習や埋め込みの利用を扱えるかどうかは個別の確認が必要であり、前提となる運用条件を事前に整理しておく必要があります。
自社で業務AIの性能改善を検討する場合、まずは毎回送信している固定のシステム指示、参照する業務マニュアル、ツール定義などを分類し、どの部分が定常的にトークンを消費しているかを整理することから始めます。その上で、現在の応答時間や処理件数、業務要件を満たす回答精度のベースラインを測定します。代表的な問い合わせパターンだけでなく、日常業務で発生する多様な問い合わせサンプルを用意し、プロンプトの調整やモデル構成の変更によって業務上の判断基準が崩れていないかを比較検証できる環境を整えることが現実的な第一歩になります。
業務整理と連携範囲の検討から進める
AIエージェントのパフォーマンス改善では、最新の圧縮手法をいきなり導入することを目指すのではなく、どの業務でどのような指示やデータを固定で扱っているのか、性能のボトルネックがどこにあるのかを見極めることが欠かせません。
デノフでは、デノフのサービス案内に記載のとおり、社内業務システムの設計・開発やAI導入に向けた業務整理、ツールの選定支援を行っています。固定で参照している業務規則やデータ連携の構造を整理し、現状の処理速度や精度の測定方法、どこまでを標準機能で対応しどこから個別のシステム連携や開発を検討すべきかといった検証範囲を具体化したい場合は、デノフへの相談窓口よりお問い合わせください。個別の業務フローや既存システムの構成に合わせた整理を進めることができます。