2026年9月28日、AWSはAmazon BedrockにおいてxAIのフロンティアモデル「Grok 4.7」の提供を開始したと発表しました。AWSによるGrok 4.7の提供開始告知では、前世代のGrok 4.6と比べて、文書が混在する処理の向上、計画やエラー回復を伴うリポジトリ規模のコーディング、フォーム入力やポータル移動を行うブラウザ操作エージェントの強化が図られたと説明されています。
入力形式としてはテキストと画像に対応しており、社内文書や画像資料を扱うバックオフィス業務や開発支援での活用が期待されます。ただし、これらは提供元による機能説明であり、日本の個別企業が運用中の実務システムへそのまま導入できるかを判断するには、インフラ構成や接続仕様に踏み込んだ確認が欠かせません。
東京リージョン名と実際の処理地域を混同しない注意点
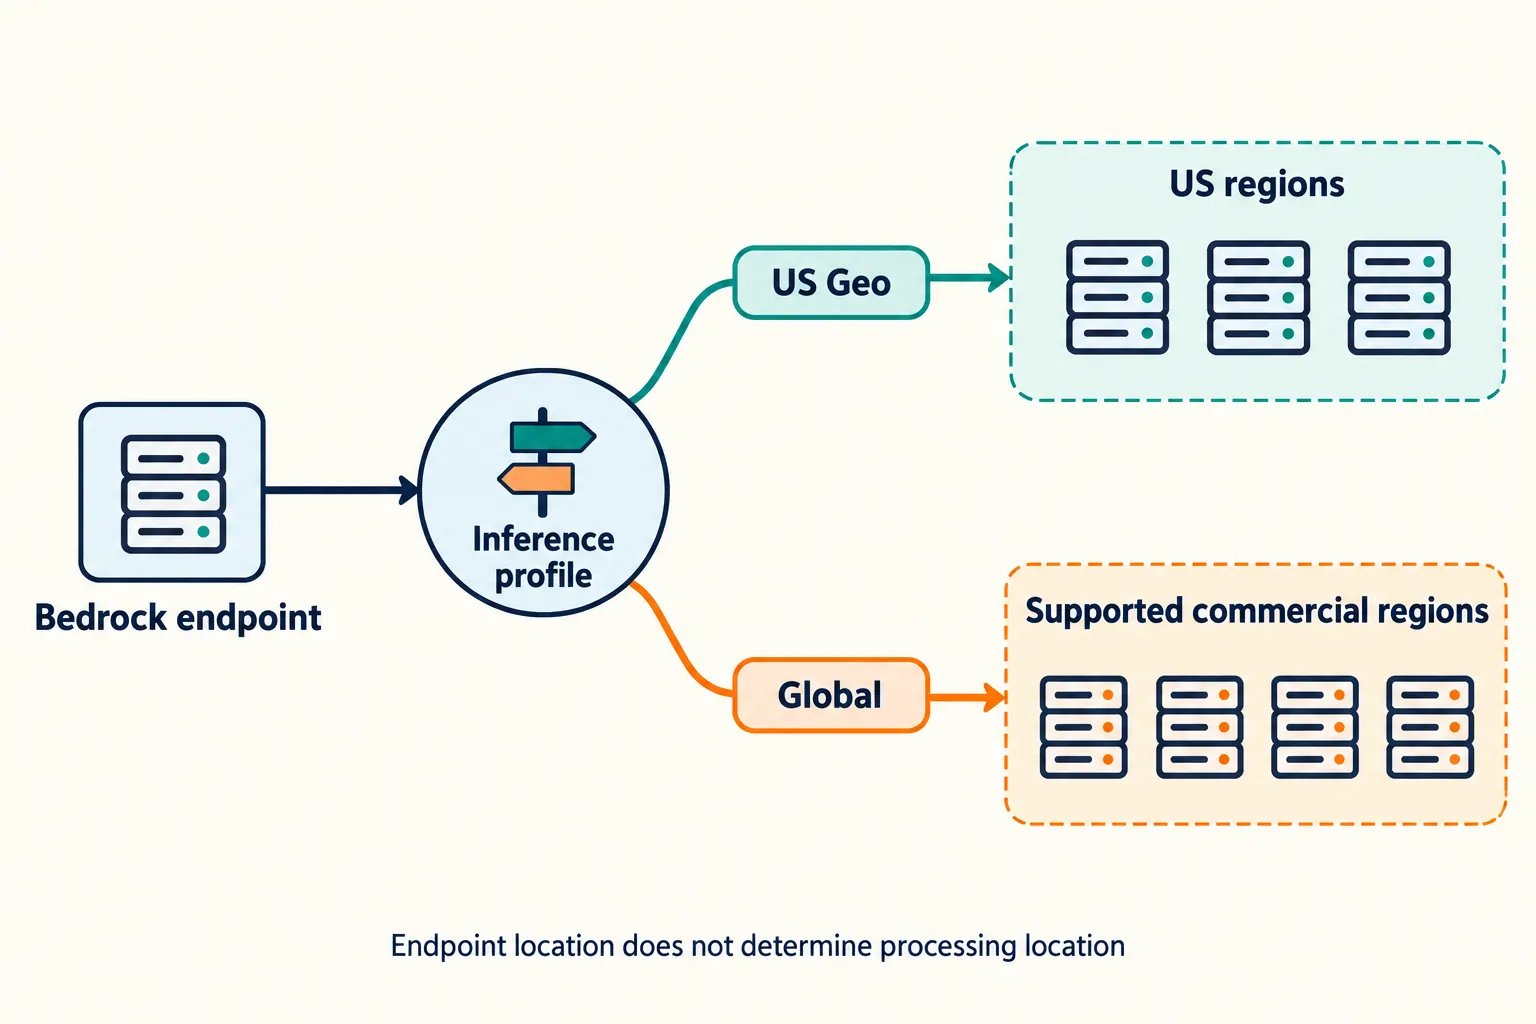
社内文書や業務データをクラウドAIに渡す際、企業にとって重要な論点の一つが「データがどの地域で処理されるか」です。Amazon BedrockでGrok 4.7を呼び出すにあたっては、この点に固有の前提条件が存在します。
Amazon BedrockのGrok 4.7モデル資料によると、bedrock-runtimeエンドポイントにおけるGrok 4.7の推論は、地理的範囲を米国内に限定する「US Geo」または世界各地の商用リージョンを活用する「Global」のクロスリージョン推論で提供されています。特定の単一リージョン内だけで処理を完結させるIn-Region推論は、このエンドポイントでは利用できません。
Bedrockのルーティング仕様については、モデル別のリージョン対応状況を解説した公式ドキュメントに詳細が示されています。Geoは指定された地理的範囲内(USなど)のリージョン間でリクエストを分散しつつデータをその境界内に留める方式であり、Globalは全世界の対応商用リージョンへリクエストを振り分ける方式です。資料の一覧に東京(ap-northeast-1)などの名称が記載されていたとしても、Grok 4.7の推論方式はUS GeoおよびGlobalであり、In-Region推論には非対応とされているため、地域名の掲載だけでデータ処理が日本国内にとどまると判断することはできません。
そのため、社内規程やコンプライアンス要件で日本国内での処理が必須とされている業務文書については、現行の提供条件との整合性を慎重に確認する必要があります。
OpenAI互換SDKによる接続とIAM権限の設定
既存のシステムにGrok 4.7を組み込む際、開発面での大きな特徴となるのがAPIの接続仕様です。公式の利用サンプルでは、Responses APIおよびChat Completions APIの呼び出しにOpenAI Python SDKを使用する構成が示されています。
この互換エンドポイントを利用する場合でも、リクエストはAmazon Bedrock上でホストされるxAIモデルを呼び出すため、データがOpenAI側に送信されることはないと資料に明記されています。既存のシステムでOpenAI向けクライアントライブラリを利用している場合は、接続先のベースURLとAPIキーをBedrock向けに切り替えることで、通信層の設計を活かせる可能性があります。
ただし、呼び出しの実装にはBedrock固有の指定が求められます。モデル指定パラメータには、モデルID単体ではなくクロスリージョン推論プロファイル(us.xai.grok-4.7 または global.xai.grok-4.7)を渡す必要があります。さらに、実行するIAMアイデンティティには、推論プロファイルへのアクセス権限だけでなく、対象アカウントのdefault project(arn:aws:bedrock:{region}:{account-id}:project/default)に対する bedrock:InvokeModel 権限も付与されている必要があります。単なるライブラリの流用にとどまらず、AWS側の認証基盤と権限設計を合わせて見直すことが不可欠です。
国内業務への導入を検討する試行アプローチ
新モデルを自社の業務改善に取り入れる場合、いきなり広範な業務へ展開するのではなく、影響範囲を限定した検証から着手するのが現実的です。
たとえば、ある卸売企業が社内の商品管理画面に登録する商品説明文の下書き作成を検討する場面を想定してみます。取り扱う資料の中から、社外送信に関してセキュリティ上の懸念がない商品カタログや仕様書、製品画像を選定し、下書き生成の入力データとします。生成された下書きは自動で本番登録せず、担当者が元の資料と照合しながら画面上で確認・修正を行ってから保存する運用フローを組み立てます。
このプロセスを形にするには、設定変更だけで済む範囲と個別開発が必要な範囲を見極める必要があります。公式ドキュメントから確認できるのは、推論プロファイルの指定や互換SDKの呼び出し例、IAM権限といった接続の枠組みまでです。社内システムから対象の文書や画像を抽出してAPI向けの形式に変換する処理や、モデルからの応答を受け取って画面に表示するUIの改修、エラー発生時の例外処理などは、既存機能や設定で対応できるかをまず調査し、不足する場合に自社のシステム構成に合わせた個別の設計・実装を検討することになります。
業務の整理とシステム連携の進め方
新しいAIモデルが登場した際、機能の高さだけに目を向けるのではなく、自社のどの業務に適合し、データ管理上の基準を満たせるかを整理することが、安定した導入への第一歩となります。
株式会社デノフでは、Web・システム開発からAI活用支援までのサービスを提供しています。社内業務のどこにAIを組み込むべきかの課題整理やツール選定、自社の運用に合わせた自動化の仕組みづくり、既存業務システムと外部APIの接続改修など、要件整理から実装まで継続して支援を行っています。
「既存の文書処理業務にAIを組み込みたいが、データの取り扱いやAPIの接続設計をどのように整理すべきか迷っている」という段階からご相談いただけます。具体的な連携範囲や開発の進め方を検討されたい企業様は、デノフへのお問い合わせ窓口よりお気軽にご連絡ください。