サポートデスクや営業支援において、社内に蓄積されたナレッジを生成AIに参照させる取り組みが進んでいます。2026年9月23日、AWSはAmazon Bedrock Managed Knowledge Base向けにSalesforceとZendeskのデータソースコネクターを発表しました。
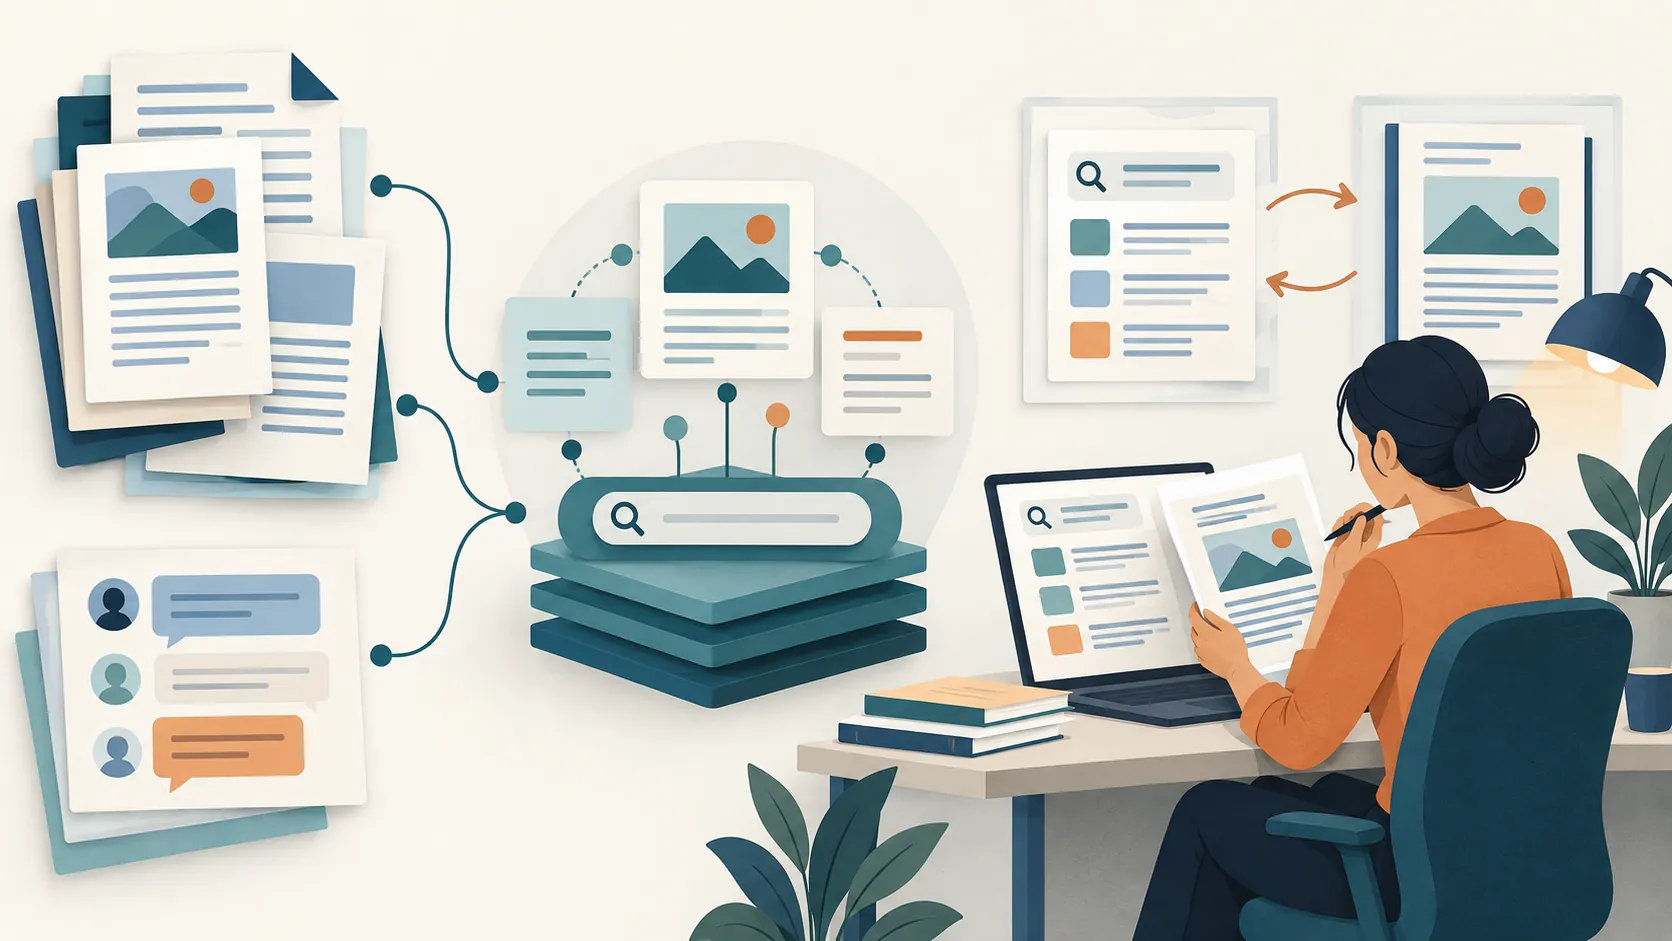
これまで両プラットフォームのコンテンツをBedrockに取り込むには、独自のデータ取り込みパイプラインを設計・構築する必要がありました。今回のコネクターを利用することで、対象インスタンスの認証情報を提供するだけで、データのクロール、メタデータの抽出、増分同期が自動で処理されるようになります。
ただし、同期の対象として明記されているのは、Salesforceのナレッジ記事と、Zendeskのヘルプセンター記事およびコミュニティ投稿です。顧客管理(CRM)の全データや、日々やり取りされる問い合わせチケット全体が自動で同期されるわけではない点に注意が必要です。
取り込みから検索最適化までを基盤側が担う範囲
取り込み後のデータ処理については、Amazon Bedrock Knowledge Basesが備えるフルマネージド機能が役割を果たします。データの取り込みだけでなく、ベクトルストアへの保存や検索処理の最適化までがサービス側で管理されます。
また、ドキュメントのチャンク分割やテキスト解析の戦略についても既定の設定が用意されており、必要に応じて利用者がカスタマイズできる構成となっています。これにより、検索基盤そのものの構築やインフラ運用の負担を抑えながら、RAG(検索拡張生成)の仕組みを立ち上げやすくなりました。
一方で、元のサービス側で設定された閲覧権限が検索結果へどのように反映されるかや、更新・削除された記事の反映遅延、記事とコミュニティ投稿をどの粒度で選別できるかといった具体的な仕様は、導入時に個別確認が必要です。
管理された記事とコミュニティ投稿の扱い
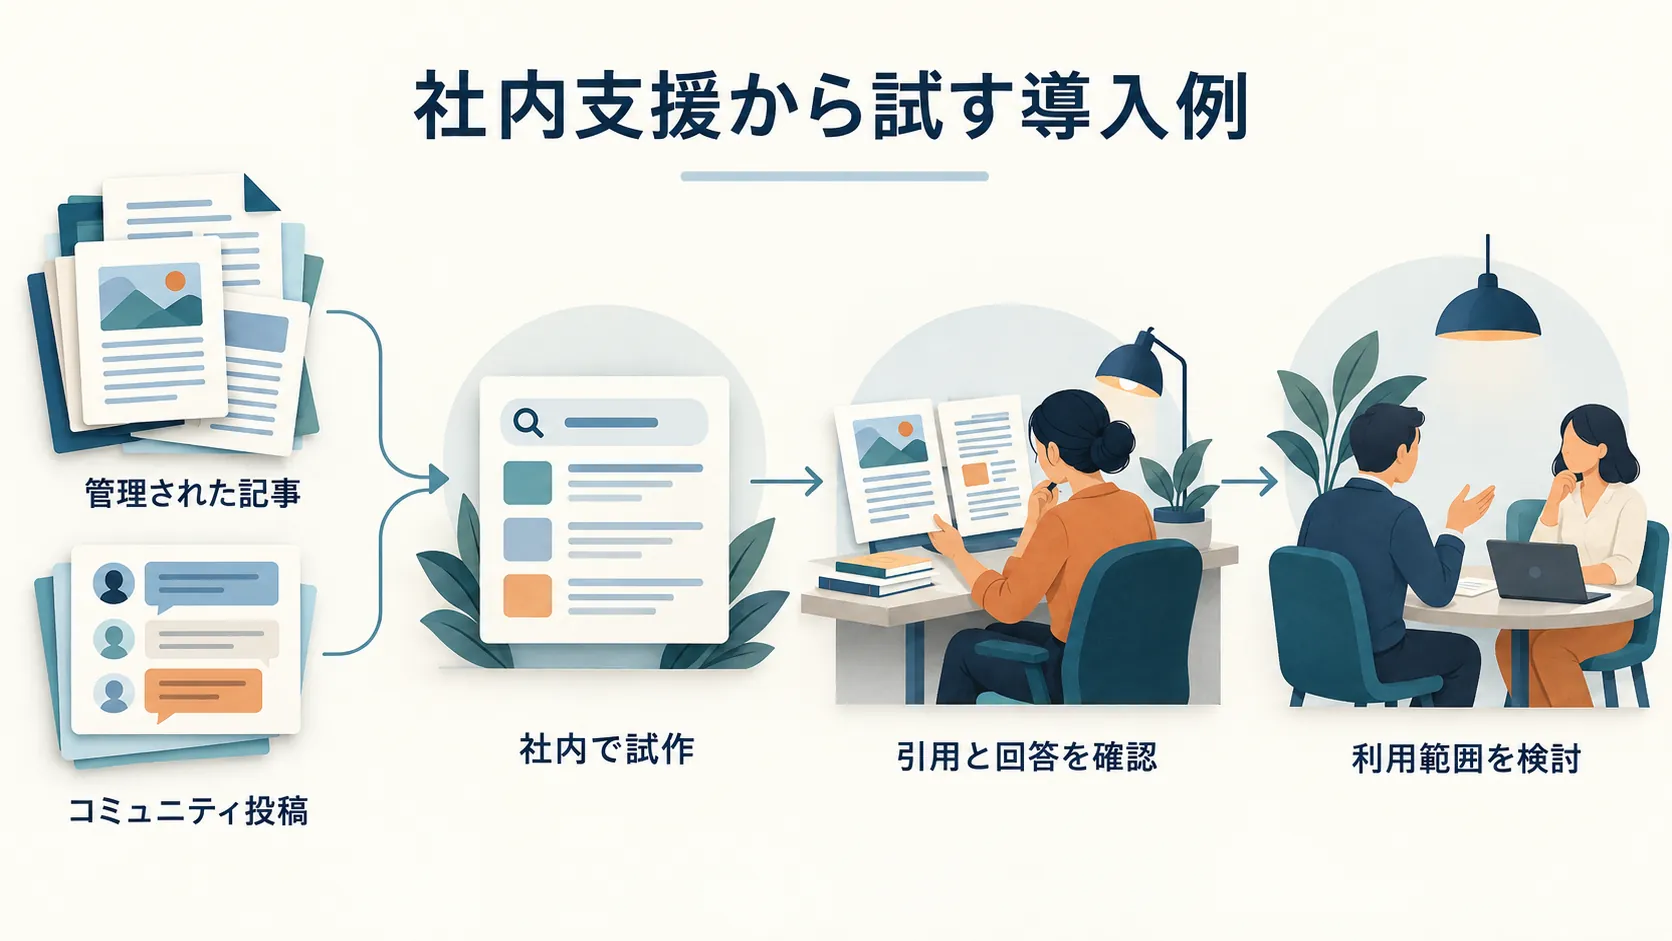
今回のコネクターでは、公式に管理されたナレッジ記事だけでなく、Zendeskのコミュニティ投稿も同期対象に含まれています。AWSの発表資料では、Zendeskの記事やコミュニティ回答を参照する顧客向けサポートボットや、商談準備でSalesforceのナレッジを検索する社内営業支援アシスタントが利用例として挙げられています。
ここで実務上の論点となるのが、AIに渡す情報の性質です。公式にメンテナンスされたマニュアル記事と、ユーザー同士のやり取りであるコミュニティ投稿では、個々の情報の管理・更新状況によって正確性や最新性の水準が異なる可能性があります。顧客へ直接返す自動応答の根拠としてコミュニティ投稿まで含めるのか、それとも社内担当者が参考にする補助情報にとどめるのかによって、検索対象の切り分けが必要になります。
例えば、国内の製品サポート部門がZendeskの記事とコミュニティ投稿を保有している場面を想定してみます。いきなりエンドユーザー向けの全自動回答を目指すのではなく、まずは問い合わせ対応を行う担当者向けの社内検索アシスタントとして試作する進め方が考えられます。代表的な問い合わせに対して適切な記事が引用されるか、投稿内容が誤解を招かないかを確認し、回答確認の手順を整えてから利用範囲を広げることで、実務に即した運用を組み立てやすくなります。
業務に合わせたAI検索の導入と接続の相談
コネクターによって外部サービスからのデータ取り込みが容易になっても、AI検索を実際の業務へ組み込むには、事前の情報選別が欠かせません。どの記事を参照元にし、誰が回答内容を確認するかといった実務フローを具体化するとともに、利用形態に応じて単独での利用や既存機能で対応できるか、既存の業務画面への組み込みが必要かを検討します。既存画面への組み込みを希望する場合には、どこに検索結果を表示してどう連携させるかといった設計を進める必要があります。
デノフでは、Webサイト・業務システムの設計・開発やAI活用支援において、業務の整理からAIを活用する業務の選定、ツール選定、既存システムとの連携要件の定義までを一貫して支援しています。既存のサポート記事や社内資料を活かしたAI検索の導入、限定したデータでの試作評価、業務フローに合わせたインターフェースの構築をご検討の際は、デノフの相談窓口よりお気軽にお問い合わせください。