社内の手順書や技術文書、障害対応の記録をセルフホスト環境のConfluence Data Centerに蓄積している組織では、それらを社内AIの参照データとして活用できます。2026年9月9日、AWSはConfluence Data Center向けネイティブデータソースコネクタの発表を行い、Amazon Bedrock Managed Knowledge Baseにおいて直接のデータ取り込みに対応したことを明らかにしました。
公式コネクタが担う取り込み処理と絞り込みの仕組み
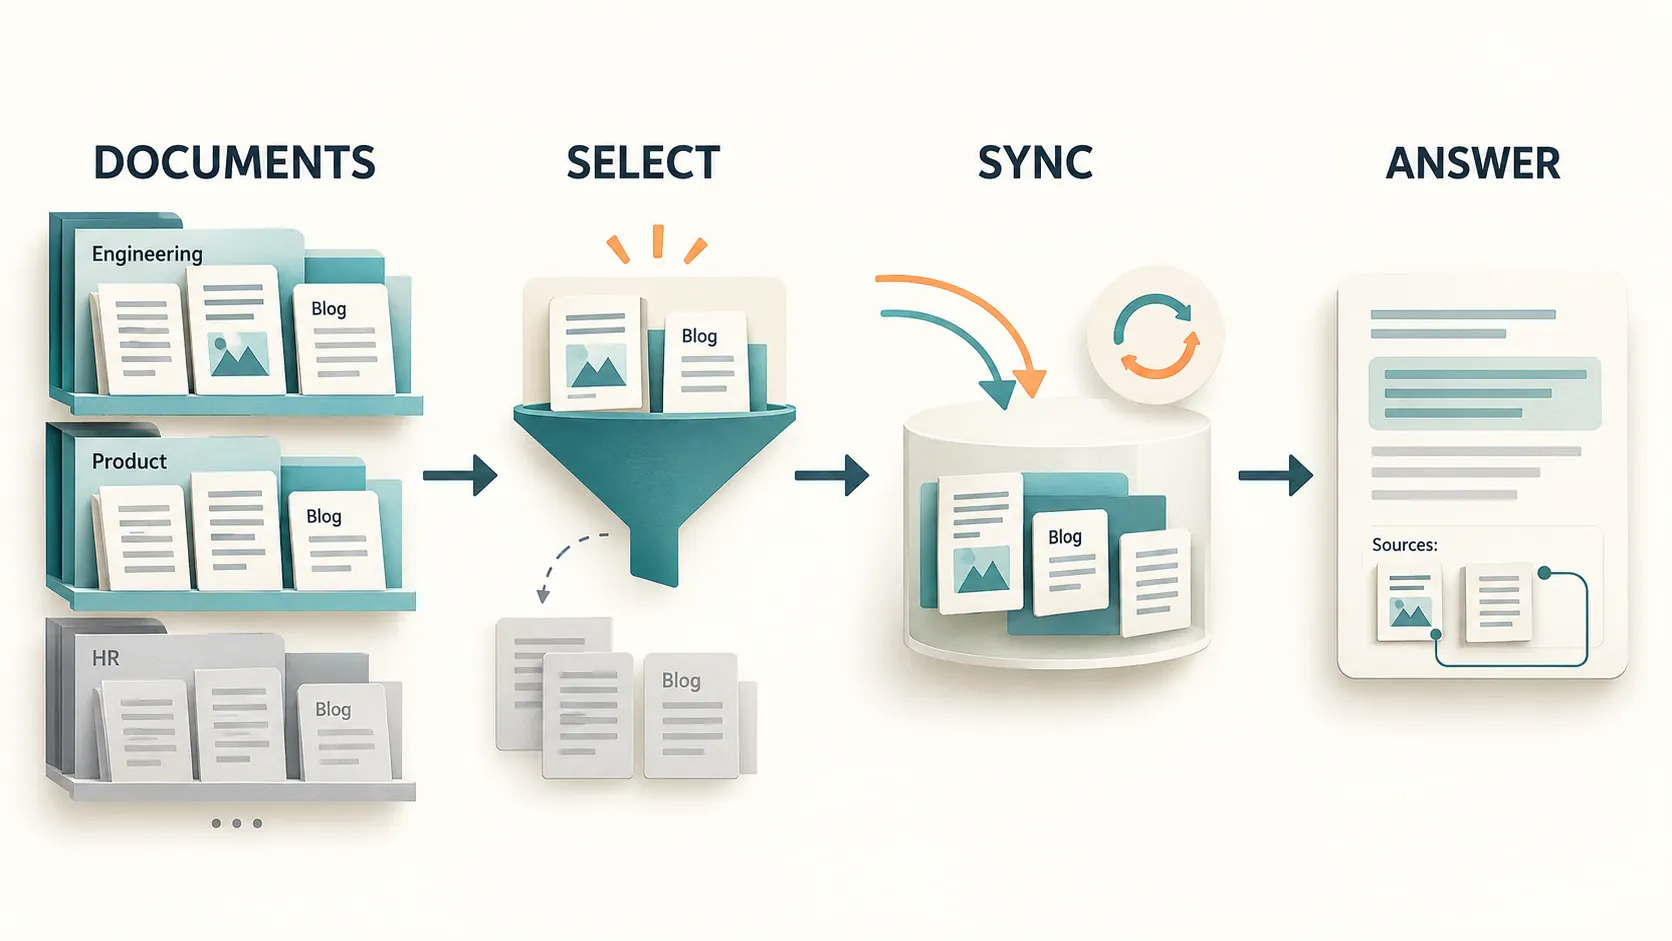
従来、Confluence Data Centerの文書群をBedrock Knowledge Basesへ取り込むには、独自に取り込みパイプラインを構築して運用する必要がありました。今回の発表によると、インスタンスの認証情報を設定することで、スペース内のページやブログのクロール、メタデータの抽出、増分同期がコネクタ側で自動処理されるようになります。
機能面で注目されるのが、クロール対象を特定のスペースやコンテンツ種別に限定できるフィルタ機能です。社内のConfluenceには、現在も参照されている正式な業務手順書だけでなく、過去の検証ログや個人の作業メモ、更新が止まった古い議事録などが混在しがちです。全量をAIへ渡すのではなく、必要なスペースやページ種別にあらかじめ範囲を絞り込むことで、関連性の高い情報に限定した知識基盤を保ちやすくなります。
コネクタを通じてデータが取り込まれた後の基盤運用については、Amazon Bedrock Knowledge Basesの公式情報にある通り、非構造化データの取り込みからベクトルストレージの管理、埋め込み、再ランキング、検索最適化までがマネージドサービス側で担われます。ただし、今回の発表資料内では、具体的な利用可能リージョンや利用料金、Confluence側のアクセス権限がAIの検索結果にどのように引き継がれるかといった詳細な仕様までは確認できません。導入を検討する際は、最新の公式ドキュメントで要件を満たしているかを確かめる必要があります。
全量を渡す前に社内業務のどこで使うかを切り分ける
取り込みの自動化が進んだとしても、AIが正確な回答を返せるかどうかは、参照元となる文書の管理状態と利用業務の設計に依存します。フィルタ設定によって技術的な取り込み対象を絞り込めたとしても、元の文書に古い手順や矛盾する記述が含まれていれば、生成される回答にもその不整合が反映されるためです。
たとえば国内企業の架空のケースとして、情報システム部門が保守手順や障害対応記録をConfluence Data Centerで運用しており、社内一次問い合わせの回答候補をAIに提示させる場面を考えます。この場合、いきなり全スペースを検索対象にするのではなく、現在有効な保守手順書がまとまったスペースに限定し、最終的な回答の採否は担当者が確認する運用から始める形が現実的です。
自社で導入計画を立てる際は、まずAIに支援させたい業務を特定し、その業務で正解とみなせる文書がどのスペースに存在するかを棚卸しすることが第一歩になります。同時に、古い文書の更新責任者を明確にし、AIが提示した根拠を人が確認して判断するプロセスをあらかじめ決めておくことで、誤った情報による現場の混乱を防ぐことにつながります。
AI導入の業務整理と連携範囲のご相談
既存の文書基盤を社内AIと連携させる取り組みでは、ツールの接続設定だけでなく、どの業務にAIを適用し、どのデータを参照させるかという事前の要件定義が成果を左右します。デノフのサービス案内では、中小企業をはじめとする現場の業務整理から、AIを活用する業務の選定、既存システムやナレッジとの連携範囲の検討まで、実践的な導入支援を提供しています。
社内に蓄積されたナレッジの活用方針や、段階的な導入に向けた検証項目の整理をご検討の際は、デノフへの相談窓口よりお気軽にお問い合わせください。現状の業務課題や運用体制に応じた進め方を具体化するお手伝いをいたします。