2026年9月29日発表、アジア3拠点へのClaude提供拡大と対応モデル
AWSは2026年9月29日、Amazon BedrockにおいてAnthropicのClaudeシリーズの提供地域を拡大し、インド、韓国、シンガポールで利用可能になったことを発表しました。金融やヘルスケア、公共部門など、特定の地理的境界内でデータを処理したい利用者を想定し、各国内で推論を行える構成が案内されています。
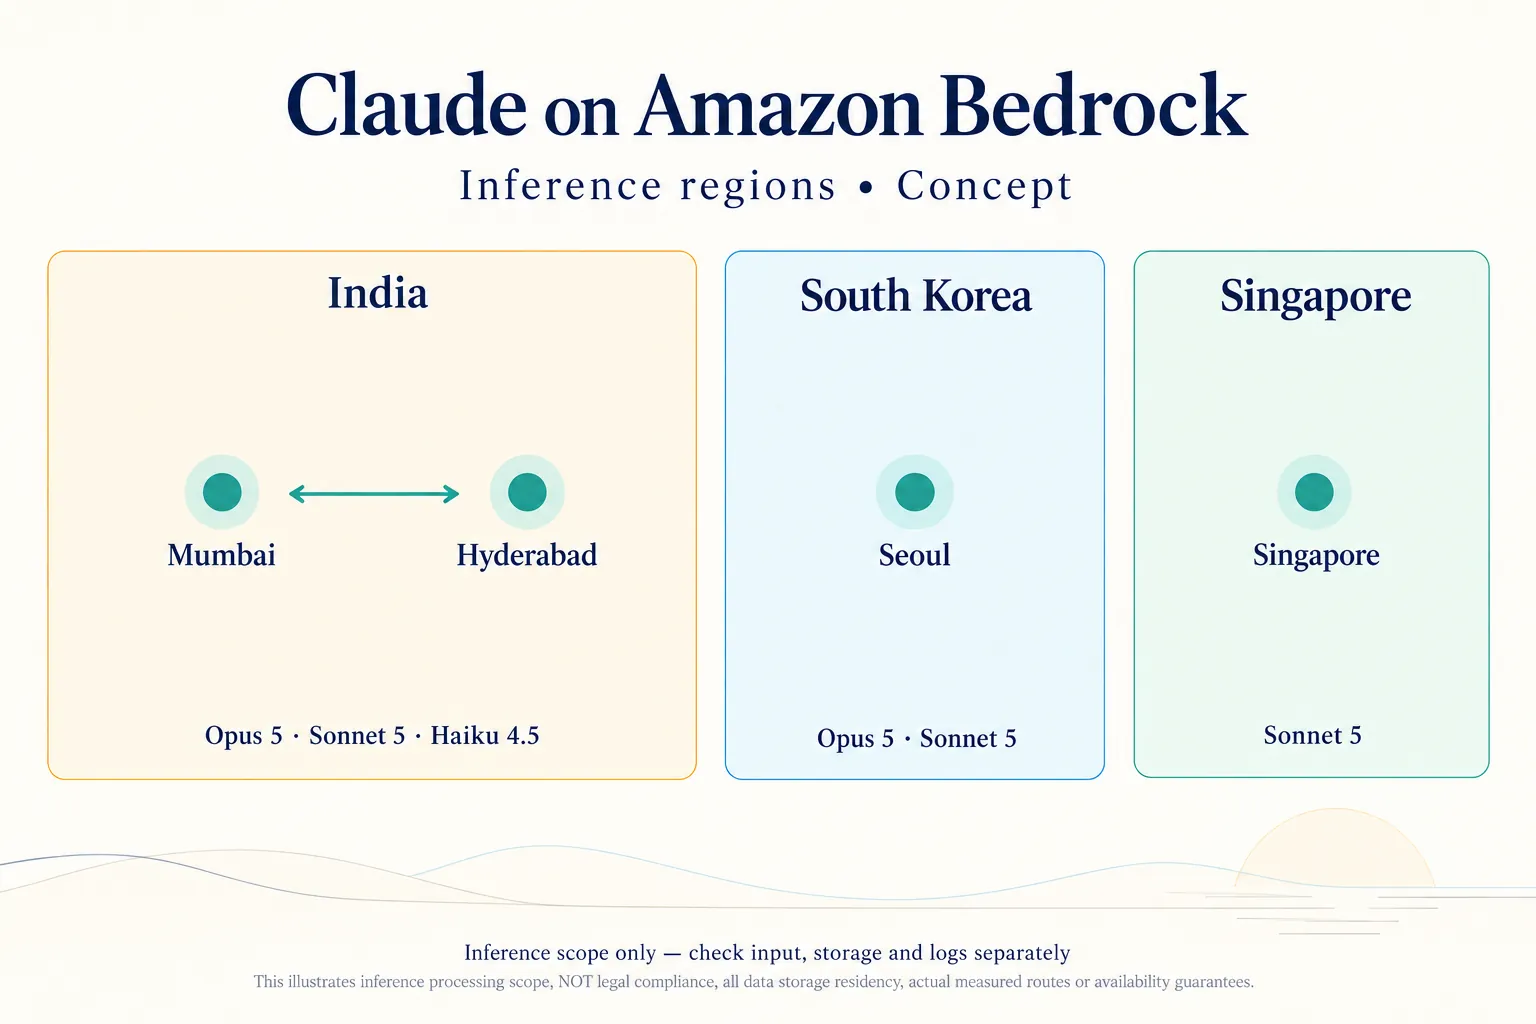
今回の発表で注意したいのは、提供されるモデルの顔ぶれが国ごとに異なる点です。原典であるAWSの地域拡大発表(英語)によると、各国で利用できるモデルは次の通り案内されています。
- インド:Claude Opus 5、Claude Sonnet 5、Claude Haiku 4.5
- 韓国:Claude Opus 5、Claude Sonnet 5
- シンガポール:Claude Sonnet 5
たとえばHaiku 4.5を利用したい場合は今回の発表ではインド拠点が選択肢に入りますが、韓国やシンガポールについては今回の発表対象に含まれていません。現地拠点で必要とするモデルが提供対象に含まれているかをあらかじめ確認する必要があります。
地理的クロスリージョン推論とリージョン内推論の違い
モデルの違いに加えて確認したいのが、推論リクエストが処理される範囲です。同じ「国内での推論」という表現でも、技術的な提供方式は国によって分かれています。
韓国ではソウル(ap-northeast-2)、シンガポールでは現地リージョン(ap-southeast-1)のbedrock-runtimeエンドポイントにおいて、同一リージョン内で完結するリージョン内推論(in-region inference)が提供されます。AWSの説明では、呼び出したリージョン内でリクエストとデータが処理され、そのリージョン外に出ることはないとされています。
一方、インドにおける地域エンドポイントは、Mumbai(ムンバイ)とHyderabad(ハイデラバード)の2つのリージョンをまたぐ「地理的クロスリージョン推論(geographic cross-Region inference)」として提供されます。処理はインド国内のリージョン内に留まりますが、特定の単一リージョンだけに固定されるわけではありません。そのため、社内規程や顧客契約において「インド国内にあれば問題ない」のか、それとも「特定のデータセンターや単一リージョンに固定しなければならない」のかによって、適合性の判断が分かれます。
エンドポイントURLだけでなく推論プロファイルIDの確認が必要な理由
既存の業務システムからBedrockを呼び出している場合、接続先URLを変更するだけでは意図した処理場所に限定できない場合があります。
Claude Sonnet 5の公式ドキュメント(英語)では、データ所在地を制御する仕組みとして推論プロファイルIDが定義されています。Sonnet 5でIndia geoを利用してインド国内のリージョン内にデータを保つ構成では、インド地域向けの推論IDである「in.anthropic.claude-sonnet-5」を指定します。一方、所在地の制約なく世界中のリージョンへルーティングする「global.anthropic.claude-sonnet-5」を指定した場合は、国外を含むリージョンへルーティングされ得る構成になります。
同ドキュメントでは、us-east-1エンドポイントURLを用いながら、推論プロファイルIDにglobalを指定して呼び出すコード例が掲載されています。つまり、接続先URLに地域名が含まれていても、推論プロファイルIDの指定次第でグローバルへ転送される構成が標準的に存在します。意図した国内処理を実現するには、呼び出し元のアプリケーションコードや設定ファイルで指定しているモデルIDや推論プロファイルIDを合わせて確認することが不可欠です。
海外拠点の問い合わせ文書を要約する仮定例とデータ経路の整理
自社の業務へ落とし込む際は、推論処理そのものだけでなく、前後のシステムを含めた全体のデータの流れを整理する必要があります。
たとえば、日本国内の本社とインド拠点を展開する企業が、現地の問い合わせ対応業務で届く顧客文書をClaude Sonnet 5で要約する場面を考えてみます。社内方針として「インド拠点で受領した顧客文書はインド国内でAI処理を完結させる」という要件がある場合、モデル呼び出しには先述のIndia geo推論IDを選択することになります。
ただし、推論場所をインド国内に限定したとしても、業務全体が自動的に国内限定になるわけではありません。現地システムのデータベースから文書を取得する経路、BedrockへのAPI呼び出し、要約結果を保存するストレージ、さらにはエラーログの出力先や本社管理システムへ連携する情報の範囲まで、データがどこを経由してどこに保管されるかを個別に確認する必要があります。推論処理がインド国内で行われていても、ログや要約結果が別の国のサーバーへ転送されていれば、拠点側の管理基準とずれてしまう可能性があるためです。
自社で確認を進める手順と小規模な検証
社内システムの改修や接続先の見直しを検討する際は、業務要件の明確化から段階的に進めることが現実的です。
まずは対象文書に求められる要件が「国内(複数リージョン可)」なのか「特定リージョン内」なのかを明確にします。次に、既存の業務アプリケーションがBedrockを呼び出している箇所を調査し、指定されているエンドポイントURLとモデルID(または推論プロファイルID)の組み合わせを照合します。さらに、入力データの取得元から推論後の保存先までのデータ移動先を洗い出します。
いきなり本番環境の接続を切り替えるのではなく、機密情報を含まないテスト用のサンプル文書を用い、APIの呼び出しと出力結果、生成されるログの記録場所を確かめる小規模な検証から着手することをおすすめします。
業務整理や既存システム接続の検討でお困りの場合
海外拠点の業務改善にAIを取り入れる際は、ツールの選定だけでなく、既存の業務手順や社内システムの改修範囲をどう切り分けるかが課題になりやすいところです。
デノフでは、Webサイト・業務システムの設計・開発・運用保守やAI活用支援を行っており、業務の整理からAIを適用する領域の選定、ツールの選定、既存システムとの連携方法の検討まで一貫して支援しています。対象アカウントごとの利用権限や個別の法令適合性の保証といった前提の確認は必要ですが、「どのデータをどこで処理すべきか整理したい」「既存の社内システムとAPIをどうつなぐか改修範囲を検討したい」といった具体的な課題の整理に対応しています。
海外拠点の文書処理やデータ管理に合わせたシステム連携の進め方について検討されている方は、デノフへの相談窓口よりお気軽にお問い合わせください。